Однослойный перцептрон: математические основы, обучение и место в машинном обучении#
Учебный текст для слушателя. Составлен по плану лекции (6 часов, при сокращении — 4 часа). Формат: лекция + доска + слайды + Jupyter Notebook.
Цель: сформировать у слушателя прочный базис — понять, что такое модель, признаки, веса, смещение, функция активации, линейная разделимость, функция потерь, оптимизация, обобщение и ограничения линейных моделей.
После изучения вы сможете:
- объяснить исторические и биологические предпосылки перцептрона;
- записать математическую модель однослойного перцептрона;
- вывести правило обучения и объяснить его геометрический смысл;
- сформулировать и доказать в общих чертах теорему сходимости;
- объяснить проблему XOR и необходимость скрытых слоёв;
- реализовать перцептрон на Python/NumPy и обучить его на простых данных;
- связать перцептрон с логистической регрессией, ADALINE, SVM и современными нейросетями.
0. Введение и мотивация#
Что такое машинное обучение#
Машинное обучение — это подход, при котором мы не пишем для компьютера явные правила решения задачи, а даём ему данные и позволяем извлекать правила из них самому. Чем больше примеров видит алгоритм, тем точнее он отвечает. В этом и состоит принципиальное отличие от классического программирования: там человек заранее формулирует все «если…, то…», здесь — формулирует модель, а правила «вырастают» из данных.
Основной и самый распространённый сценарий — обучение с учителем (supervised learning). «Учитель» здесь — это разметка: для каждого примера заранее известен правильный ответ. Формально такой сценарий складывается из четырёх ингредиентов:
- Признаки — числовые характеристики объекта, по которым мы хотим делать предсказание (например, для письма — частота встречаемости слов, длина, наличие ссылок).
- Метки — правильные ответы, известные для обучающих примеров (например, «спам» или «не спам»).
- Модель — параметризованная функция, которая по признакам предсказывает метку.
- Обучение — подбор параметров модели так, чтобы её предсказания совпадали с метками.
Зачем это нужно: именно наличие модели и процедуры подбора параметров отличает машинное обучение от простого запоминания таблицы ответов.
Два понятия определяют, хороша ли модель. Риск — это ожидаемая ошибка модели: если применять её к новым, ещё не виденным объектам, в среднем она будет ошибаться с некоторой вероятностью. Обобщение — способность модели работать именно на новых данных, а не зазубривать обучающие примеры.
Пример. Врач ставит диагноз по анализам (признаки) и ставит метку «болен/здоров». Модель, которая выучила наизусть сто историй болезни, отлично «сдаст экзамен» на этих же ста карточках, но провалится на новом пациенте — у неё плохое обобщение. Модель, которая уловила общую закономерность, сработает и на новых данных, то есть имеет низкий риск.
Интуиция: обобщение — это цель, риск — это мера качества; всё остальное (выбор модели, функция потерь, оптимизация) — средства для их достижения.
Место перцептрона#
Перцептрон — простейшая обучаемая линейная модель: он принимает вектор признаков, взвешивает их и выдаёт решение по порогу. При всей своей простоте это полноценный элемент машинного обучения: у него есть модель, функция потерь, правило обновления параметров и теорема о сходимости.
Но ценность перцептрона не исчерпывается званием «первой модели». Он — «кирпич» нейросетей: любая современная глубокая сеть собирается из множества таких же линейных блоков с нелинейными активациями. Понять перцептрон — значит понять тот элементарный блок, из которого построена вся глубокое обучение.
Интуиция: если вы понимаете, как устроен один кирпич, вам не составит труда понять, как устроена стена, — и почему стена крепче одного кирпича.
Вопросы лекции#
Чтобы двигаться по материалу осмысленно, выделим четыре вопроса, на которые отвечает вся лекция:
- Как из биологической идеи о работе нервной клетки родился алгоритм?
- Почему этот алгоритм вообще работает — на каких математических основаниях?
- Когда он не работает, и что это говорит о границах линейных моделей?
- Что из перцептрона выросло — какие современные методы являются его прямыми наследниками?
Эти вопросы определяют структуру лекции: сначала предпосылки и история (данный раздел), затем математическая модель, правило обучения и теорема сходимости, далее ограничения (проблема XOR) и, наконец, путь к современным моделям.
Ключевая мысль#
Перцептрон — не просто исторический курьёз, а минимальный пример, на котором видны все базовые принципы машинного обучения: гипотеза (семейство функций, среди которых мы ищем решение), функция потерь (как измеряем ошибку), оптимизация (как ищем хорошие параметры), переобучение (почему модель может выучить шум вместо закономерности), линейная разделимость (какие задачи модель в принципе способна решить) и ёмкость (capacity — насколько сложные зависимости модель может выразить). Понимание этих принципов на простейшей модели переносится на любые, сколь угодно сложные архитектуры.
Итог раздела: Машинное обучение — это построение модели по данным, где модель предсказывает метки по признакам, а качество измеряется риском на новых данных и свойством обобщения. Перцептрон — простейшая обучаемая линейная модель и «кирпич» нейросетей, на котором удобнее всего разобрать общие принципы ML: гипотезу, функцию потерь, оптимизацию, переобучение, линейную разделимость и ёмкость. Далее в лекции мы отвечаем на четыре вопроса: откуда взялась идея, почему алгоритм работает, когда не работает и что из него выросло.
1. Предпосылки и история#
1.1. Биологические и кибернетические предпосылки#
Идея перцептрона родилась из наблюдений за биологическим нейроном. Нервная клетка устроена так: дендриты собирают сигналы от других клеток, синапсы — места контактов между нейронами, через которые эти сигналы передаются; сома (тело клетки) суммирует поступающие сигналы, и если их суммарная сила превышает некий порог активации, нейрон «срабатывает» и посылает импульс по аксону — длинному отростку, по которому сигнал уходит дальше к следующим клеткам.
Интуиция: нейрон — это преобразователь «много входов → один выход с порогом»: собери сигналы, сравни с порогом, выдай решение. Ровно так же устроена математическая модель перцептрона — взвешенная сумма входов, сравнение с порогом.
Ключевая биологическая гипотеза состоит в том, что обучение = изменение силы синапсов: когда связи между нейронами усиливаются или ослабевают, поведение всей сети меняется, и так организм запоминает опыт.
Наиболее известное правило, формализующее эту идею, — правило Хебба (1949): «fire together, wire together» — «активируются вместе — связываются вместе». Если два нейрона срабатывают одновременно, связь между ними укрепляется.
Пример. Представьте, что вы каждый день видите кошку и каждый раз говорите «кошка». Нейроны, отвечающие за образ и за слово, срабатывают вместе, связь между ними усиливается — и в итоге одного образа достаточно, чтобы активировалось слово. Так «прошивается» ассоциация.
Зачем это нужно: правило Хебба даёт идею локального правила обновления «активность на входе + ошибка на выходе → сдвиг веса», которая затем превратится в строгий алгоритм обучения перцептрона.
1.2. Математические предпосылки#
Чтобы превратить биологическую аналогию в работающий алгоритм, нужен математический аппарат. Он складывается из трёх групп понятий.
Векторы и гиперплоскость. Объект описывается вектором признаков $x = (x_1, \dots, x_n)$. Модель задаёт вектор весов $w = (w_1, \dots, w_n)$ и взвешенную сумму входов — линейную комбинацию
$$w^T x = w_1 x_1 + \dots + w_n x_n,$$которая записывается через скалярное произведение векторов $w$ и $x$. Скалярное произведение измеряет «соответствие» весов и признаков: чем больше проекция вектора признаков на вектор весов, тем сильнее модель «склоняется» к положительному ответу.
Запись $w^T x = w_1 x_1 + \dots + w_n x_n$ — это просто «перемножь парами и сложи».
Считайте, что у нас два столбика чисел: веса $w = (2, 3)$ и признаки $x = (5, 1)$. Тогда:
- $w_1 x_1 = 2 \cdot 5 = 10$
- $w_2 x_2 = 3 \cdot 1 = 3$
- $w^T x = 10 + 3 = 13$
Всё. Точки $\dots$ означают «и так же для всех остальных признаков». Значок $T$ («транспонирование») нужен математикам, чтобы записать эту сумму одной буквой: без него векторы пришлось бы расписывать в столбик. Для нас это просто «сумма попарных произведений».
Наглядно: это как сложить стоимость покупки — цена товара ($w$) помножена на количество ($x$), и всё суммируется в чек.
Зачем это нужно: скалярное произведение — компактная и дифференцируемая мера согласованности двух векторов, а это ровно то, что нужно для вычислений и обучения.
Если добавить смещение (bias) $b$, уравнение
$$w^T x + b = 0$$задаёт гиперплоскость — обобщение прямой на плоскости и плоскости в трёхмерном пространстве на случай многих измерений. Гиперплоскость делит пространство признаков на две части, поэтому расстояние от точки $x$ до неё равно
$$\frac{|w^T x + b|}{\|w\|},$$где $\|w\|$ — норма вектора весов.
Интуиция: гиперплоскость — это «разделительная линия» между классами, а расстояние до неё показывает уверенность модели в решении: чем дальше точка от границы, тем смелее предсказание.
Порог и ступенчатая функция. Чтобы превратить непрерывную величину $w^T x + b$ в дискретную метку, используют порог: если значение больше порога — класс 1, иначе — 0 (или −1). Формально это задаётся ступенчатой функцией (функцией Хевисайда), так что предсказание модели записывается как
$$\hat{y} = \begin{cases} 1, & w^T x + b > 0,\\ 0, & w^T x + b \le 0. \end{cases}$$Зачем это нужно: реальные задачи — классификации, нам нужен бинарный ответ, а не число; ступенчатая функция — простейший способ получить такое решение из линейной комбинации.
Производная, градиент и минимизация функции потерь. Чтобы обучать модель, нужно уметь измерять ошибку и направление её уменьшения. Ошибка измеряется функцией потерь (loss function) — она сравнивает предсказание $\hat{y}$ с истинной меткой и возвращает величину штрафа. Чтобы минимизировать потери, нужен инструмент поиска минимума: производная показывает скорость изменения функции в точке, а градиент — вектор частных производных по всем параметрам, указывающий направление наискорейшего возрастания функции. Двигаясь в противоположную сторону — против градиента — с шагом $\eta$, мы спускаемся к минимуму функции потерь; это и есть градиентный спуск.
Интуиция: представьте, что вы стоите в тумане на склоне оврага и хотите спуститься на дно. Вы ощущаете, в какую сторону уклон (градиент), и делаете шаг против уклона; размер шага $\eta$ — насколько смелым будет каждый шаг.
1.3. Историческая линия#
История перцептрона — это история превращения биологической метафоры в математическую теорию и целую область исследований. Пройдём её по ключевым вехам.
- 1943 — МакКаллок и Питтс: формальный нейрон. Уоррен МакКаллок и Уолтер Питтс предложили математическую модель нейрона — пороговый элемент, вычисляющий взвешенную сумму входов и сравнивающий её с порогом. Так возникла пороговая логика: оказалось, что из таких элементов можно строить логические схемы («И», «ИЛИ», «НЕ»), то есть моделировать вычисления.
- 1949 — Хебб: правило обучения. Дональд Хебб сформулировал правило «fire together, wire together»: обучение — это изменение силы связей при совместной активации нейронов. Это дало алгоритмическую идею того, как сеть может учиться.
- 1957 — Розенблатт: перцептрон. Фрэнк Розенблатт соединил формальный нейрон с правилом обучения и построил первую обучаемую модель — перцептрон, а затем реализовал её в виде аппаратного устройства Mark I Perceptron. Впервые задача классификации решалась обучением с учителем: модель исправляла веса по ошибкам на размеченных примерах, а не программировалась вручную.
- 1960 — Уидроу и Хофф: ADALINE. Бернард Уидроу и Тед Хофф разработали ADALINE (Adaptive Linear Neuron) — линейную модель с непрерывным выходом. Её обучение шло по методу наименьших квадратов (LMS, Least Mean Squares) и дельта-правилу — правилу обновления весов пропорционально ошибке. Это был шаг от дискретного порога к гладкой оптимизации.
- 1962 — Новиков: теорема сходимости. Альберт Новиков доказал теорему сходимости перцептрона: если классы линейно разделимы, то алгоритм обучения гарантированно найдёт разделяющую гиперплоскость за конечное число шагов. Появилась математическая гарантия работы алгоритма, а не только эмпирическая.
- 1969 — Минский и Паперт: критика. Марвин Минский и Сеймур Паперт опубликовали книгу «Perceptrons», где строго показали ограничения однослойного перцептрона: он не может решить задачу XOR (логическое «исключающее ИЛИ») — простейшую, но линейно неразделимую задачу. Это нанесло сильный удар по optimism вокруг модели и привело к так называемой AI winter — периоду стагнации и сокращения финансирования исследований нейросетей.
- 1986 — backpropagation. Возрождение началось с алгоритма обратного распространения ошибки (backpropagation) для обучения многослойных сетей: скрытые слои с нелинейными активациями преодолели ограничение XOR, потому что многослойная сеть уже не обязана быть линейной.
- 1990-е–2000-е — SVM и статистическое обучение. Фокус сместился на SVM (машины опорных векторов), статистическое обучение и ядра (kernel methods) — методы, которые позволяли строить нелинейные разделяющие поверхности, оставаясь в рамках хорошо изученной выпуклой оптимизации.
- 2010-е — глубокое обучение. Рост вычислительных мощностей и объёмов данных сделал возможным глубокое обучение — сети с десятками и сотнями слоёв. Но и в них перцептрон остаётся базовым блоком: каждый нейрон современной сети — это, по сути, тот же линейный блок с нелинейной активацией, потомок перцептрона Розенблатта.
Итог исторической линии: простая модель породила целую область — сначала дав язык описания нейронных вычислений, затем первую обучаемую модель, затем математические гарантии сходимости. А её ограничения (XOR) не уничтожили идею, а стимулировали развитие: многослойные сети, SVM, ядра и, наконец, глубокое обучение выросли ровно из попыток преодолеть недостатки перцептрона.
Итог раздела: Биологический нейрон (дендриты, синапсы, сома, аксон, порог) дал структурную аналогию, а гипотеза «обучение = изменение силы синапсов» и правило Хебба («fire together, wire together») — идею обучения. Математическим фундаментом стали векторы, скалярное произведение, гиперплоскость $w^T x + b = 0$, порог и ступенчатая функция для перехода к метке, а также производная, градиент и минимизация функции потерь для обучения. Историческая линия 1943–2010-х — от формального нейрона МакКаллока и Питтса через перцептрон Розенблатта (1957), ADALINE (1960) и теорему Новикова (1962) к кризису после «Perceptrons» (1969), возрождению через backpropagation (1986), SVM и ядрам (1990-е–2000-е) и глубокому обучению (2010-е) — показывает, что простая модель породила целую область, а её ограничения стали двигателем развития.
2. Математическая модель однослойного перцептрона (50 мин)#
Прежде чем говорить об обучении, нужно точно договориться о том, что такое однослойный перцептрон как математический объект. В этом разделе мы введём все обозначения, разберём функции активации, поймём геометрический смысл модели и выясним, какие задачи она принципиально может решать, а какие — нет. Именно здесь закладывается язык, на котором мы будем говорить о признаках, весах, смещении и линейной разделимости на протяжении всей лекции.
2.1. Обозначения#
Однослойный перцептрон получает на вход вектор признаков и выдаёт одно число — ответ модели. Формально модель описывается четырьмя ингредиентами: входом, весами, смещением и функцией активации.
Как читать формулы. Прежде чем нырять, запомним несколько значков — они будут попадаться постоянно.
- $x_i$ — просто «$i$-й признак». Нижний индекс — это номер, как квартира в подъезде: $x_1$ — возраст, $x_2$ — доход и так далее.
- $x \in \mathbb{R}^n$ — «$x$ — это набор из $n$ чисел». Значок $\in$ читается «принадлежит», $\mathbb{R}$ — множество всех чисел, а $n$ — сколько их.
- $\sum_{i=1}^{n}$ — «сложи всё от первого до $n$-го». Например, $\sum_{i=1}^{3} x_i$ — это $x_1 + x_2 + x_3$. Большая буква $\Sigma$ — просто «плюс, много раз».
- $w^T x$ — скалярное произведение: перемножаем попарно и складываем, $w_1x_1 + w_2x_2 + \dots$
- $\|w\|$ — длина (модуль) вектора $w$: корень из суммы квадратов его координат.
- $\nabla L$ («набла») — градиент, вектор из всех производных. Грубо: «в какую сторону функция растёт быстрее всего».
- $\leftarrow$ — «заменить на новое» (как знак $=$ в программировании: $w \leftarrow w + \dots$ значит «взять старое $w$ и заменить на новое»).
Если что-то из этого забылось — возвращайтесь сюда, как к словарику.
Вход. Пусть объект описывается $n$ числовыми признаками. Тогда входом модели является вектор
$$ x \in \mathbb{R}^n, \qquad x = (x_1, x_2, \dots, x_n)^T. $$Каждая компонента $x_i$ — это отдельный признак: например, для задачи про кредит это может быть возраст, доход, сумма запрошенного кредита; для задачи про рукописные цифры — яркость отдельного пикселя изображения.
Веса. Каждому признаку модель сопоставляет вес — число, показывающее, насколько сильно этот признак влияет на ответ:
$$ w \in \mathbb{R}^n, \qquad w = (w_1, w_2, \dots, w_n)^T. $$Большой по модулю вес означает, что признак важен: небольшое изменение этого признака сильно меняет ответ модели. Вес со знаком «минус» означает, что признак работает «против» положительного ответа, со знаком «плюс» — «за» него.
Смещение (bias). Кроме весов у модели есть скалярное число $b \in \mathbb{R}$ — смещение. Оно сдвигает порог принятия решения и позволяет модели отвечать правильно даже тогда, когда все признаки равны нулю. Без смещения гиперплоскость решения всегда проходила бы через начало координат, что сильно ограничило бы модель.
Линейная комбинация. Сначала перцептрон вычисляет взвешенную сумму признаков с добавлением смещения — так называемую линейную комбинацию:
$$ z = w^T x + b = \sum_{i=1}^{n} w_i x_i + b. $$Читается: z — это сумма «признак × важность» плюс сдвиг — «взвешенное голосование» признаков>
Здесь $w^T x$ — скалярное произведение вектора весов и вектора признаков: каждое слагаемое $w_i x_i$ — это «вклад» $i$-го признака в итоговое число $z$.
Разберём формулу $z = w^T x + b$ по кусочкам — так, будто мы вообще не знаем математики.
- $x$ — это «карточка объекта» с числами-признаками. Пусть мы решаем, дадут ли кредит, и признаков всего три: возраст, доход, сумма кредита. Тогда $x = (35,\ 60,\ 200)$ — это один конкретный клиент.
- $w$ — «важность» каждого признака. Например, $w = (0{,}1,\ 0{,}5,\ -0{,}4)$: доход важен и «за» кредит (вес $+0{,}5$), а большой запрошенный кредит — «против» (вес $-0{,}4$).
- $w_i x_i$ — вклад одного признака. Доход даёт $0{,}5 \cdot 60 = 30$, сумма кредита — $(-0{,}4)\cdot 200 = -80$, возраст — $0{,}1\cdot 35 = 3{,}5$.
- $w^T x$ — просто сумма всех вкладов: $30 + (-80) + 3{,}5 = -46{,}5$. Значок $T$ («транспонирование») здесь только для того, чтобы записать сумму коротко одной буквой, а не расписывать её как длинную сумму.
- $+ b$ — «сдвиг порога». Скажем, $b = 20$: это как будто у модели есть своя планка «по умолчанию». Итог $z = -46{,}5 + 20 = -26{,}5$.
Число $z$ может быть каким угодно (хоть $-26{,}5$, хоть $+300$) — это ещё не ответ, а «сырое мнение» модели, которое дальше превратит в класс функция активации.
Активация. Само по себе число $z$ — ещё не ответ. Модель пропускает его через функцию активации $\phi$ и получает предсказание:
$$ \hat{y} = \phi(z). $$Функция активации превращает «сырое» значение $z$ в итоговый ответ: например, в класс $0$ или $1$, в знак «$+1$» или «$-1$», или в вероятность.
Интуиция: перцептрон устроен как «взвешенное голосование» признаков. Каждый признак «кричит» со своей силой ($w_i x_i$), голоса складываются ($z$), а функция активации переводит сумму голосов в окончательное решение ($\hat y$). Такая схема — «линейная комбинация плюс нелинейная активация» — будет встречаться во всех нейросетях, вплоть до самых глубоких.
2.2. Функции активации#
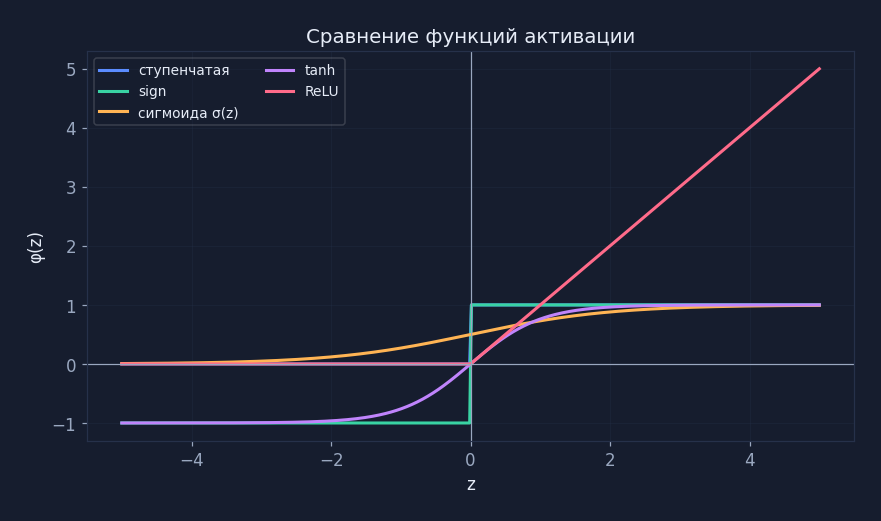
Функция активации определяет, как именно «сырое» значение $z$ превращается в ответ. Для перцептрона классически используются простая пороговая функция или знак; современные сети используют более гладкие функции, но логика остаётся той же.
Ступенчатая (пороговая) функция. Классическая активация перцептрона Розенблатта:
$$ \phi(z) = \begin{cases} 1, & z \ge 0, \\ 0, & z < 0. \end{cases} $$Она просто сравнивает $z$ с нулём: если линейная комбинация неотрицательна, модель отвечает $1$, иначе — $0$. Такой ответ удобен для бинарной классификации с классами $\{0, 1\}$.
Запись с фигурной скобкой пугает зря — читается она сверху вниз как обычный «если…, то…». Строчка «$1, \& z \ge 0$» означает: если $z \ge 0$, то ответ $1$. Строчка «$0, \& z < 0$»: если $z < 0$, то ответ $0$.
То есть вся формула — это «если $z$ положительное или ноль — говорим 1, иначе — 0». Ничего больше. По сути это термометр, который показывает не градусы, а только «тепло/холодно».
Знаковая функция. Вариант для классов $\{-1, +1\}$:
$$ \phi(z) = \operatorname{sign}(z) = \begin{cases} +1, & z > 0, \\ -1, & z < 0. \end{cases} $$Она отличается только кодировкой ответов, по сути это та же идея «по какую сторону от нуля оказалось $z$». Запись с классами $\{-1, +1\}$ окажется очень удобной при выводе правила обучения и доказательстве сходимости.
Сигмоида. Гладкая функция со значениями строго между $0$ и $1$:
$$ \sigma(z) = \frac{1}{1 + e^{-z}}. $$Она не просто даёт жёсткий класс, а выражает «уверенность» модели: чем больше $z$, тем ближе ответ к $1$, чем меньше — тем ближе к $0$. Сигмоида — мостик от порогового перцептрона к логистической регрессии, где $\hat y = \sigma(w^T x + b)$ интерпретируется как вероятность принадлежности к классу.
Что тут вообще происходит — по шагам и на бытовом языке.
- $e$ — это просто число (примерно $2{,}718$), такая же константа, как $\pi$. Здесь оно нужно, чтобы строить плавную кривую.
- $e^{-z}$ — «$e$ в степени минус $z$». Если $z = 0$, то $e^0 = 1$.
- Значит, при $z = 0$ формула даёт $\sigma(0) = \frac{1}{1+1} = 0{,}5$ — ровно серединка между 0 и 1.
- Если $z$ большой и положительный (скажем, $10$), то $e^{-10}$ — крошечное число почти ноль, и $\sigma \approx \frac{1}{1+0} = 1$.
- Если $z$ большой и отрицательный (скажем, $-10$), то $e^{-z}=e^{10}$ — огромное число, и дробь $\frac{1}{\text{огромное}}$ почти ноль.
Получается плавная «S-образная» кривая: на входе любое число, на выходе — всегда что-то между $0$ и $1$. Именно поэтому сигмоиду читают как «вероятность»: $0{,}9$ — модель почти уверена в классе 1, $0{,}1$ — почти уверена в классе 0, $0{,}5$ — не знает.
tanh и ReLU. Гиперболический тангенс $\tanh(z)$ — сигмоида, сдвинутая так, чтобы значения лежали в $(-1, 1)$, а ReLU ($\phi(z) = \max(0, z)$) — простая кусочно-линейная функция. Эти активации мы не будем подробно использовать в однослойном перцептроне, но о них полезно знать: это естественный мостик к современным многослойным сетям, где пороговые функции не годятся (они не дифференцируемы), а сигмоида, tanh и ReLU — основной инструмент.
Интуиция: выбор функции активации — это выбор «языка ответов» модели. Ступенчатая и знаковая дают жёсткий класс, сигмоида — гладкость и вероятностную интерпретацию, tanh и ReLU — удобство для обучения градиентными методами. Во всех случаях геометрия модели, которую мы разберём дальше, одинакова — меняется только способ чтения ответа.
2.3. Геометрический смысл#
Самое важное для понимания перцептрона — его геометрическая картинка. Оказывается, уравнение линейной комбинации, приравненной к нулю, задаёт в пространстве признаков гиперплоскость — «разделяющую стену».
Уравнение гиперплоскости. Рассмотрим множество точек $x$, для которых
$$ w^T x + b = 0. $$В пространстве $\mathbb{R}^n$ это уравнение задаёт гиперплоскость — объект размерности $n-1$. При $n = 2$ это прямая на плоскости, при $n = 3$ — плоскость в пространстве. Эта гиперплоскость делит всё пространство признаков на две половины.
Вектор нормали и сдвиг. Вектор весов $w$ — это вектор нормали гиперплоскости: он перпендикулярен ей и указывает направление, в котором $w^T x + b$ растёт. Число $b$ — сдвиг: оно двигает гиперплоскость вдоль нормали, не меняя её ориентации. Если $b = 0$, гиперплоскость обязательно проходит через начало координат; ненулевое смещение освобождает её от этого ограничения.
Правило классификации. Для любой точки $x$ значение $w^T x + b$ — это (с точностью до нормы $w$) «расстояние со знаком» до гиперплоскости. Поэтому классификация перцептроном устроена предельно просто: модель смотрит, по какую сторону от гиперплоскости лежит точка, и относит её к соответствующему классу. Знак $z$ определяет класс: $\operatorname{sign}(w^T x + b)$.
Расстояние до гиперплоскости. Величина
$$ \frac{|w^T x + b|}{\|w\|} $$— это настоящее (евклидово) расстояние от точки $x$ до гиперплоскости $w^T x + b = 0$. Числитель $|w^T x + b|$ показывает «уверенность» модели в ответе: чем дальше точка от границы, тем больше по модулю это значение и тем надёжнее классификация. Деление на норму $\|w\|$ делает величину инвариантной к масштабированию весов: умножим все веса и смещение на 10 — уравнение границы не изменится, и расстояние должно остаться тем же, что и обеспечивает нормировка.
Почему расстояние устроено именно так — на самом житейском примере.
Представьте плоскость-стол и точку на нём. Число $w^T x + b$ показывает, насколько далеко точка ушла «в гору» от линии $w^T x + b = 0$ — но не в метрах, а в тех единицах, которые задал вектор $w$. Если все веса увеличить в 10 раз, то и это число вырастет в 10 раз, хотя сама точка никуда не двигалась.
- $|w^T x + b|$ — «насколько сильно точка по ту или другую сторону» (без знака, потому что важно только расстояние, а не сторона).
- $\|w\|$ — длина вектора весов, то есть «измерительная линейка». Она показывает, насколько «крупные» единицы мы использовали.
- Деление $\frac{|w^T x + b|}{\|w\|}$ — «переводим в настоящие метры»: делим число на нашу линейку и получаем честное расстояние.
Проверка на числах: прямая $x_1 + x_2 - 0{,}5 = 0$ (то есть $w = (1,1)$, $b = -0{,}5$), точка $(2,3)$. Числитель $= |2+3-0{,}5| = 4{,}5$. Линейка $\|w\| = \sqrt{1^2+1^2} = 1{,}41$. Расстояние $= 4{,}5/1{,}41 \approx 3{,}18$.
Пример: пусть $n = 2$, $w = (1, 1)^T$, $b = -0{,}5$. Уравнение $x_1 + x_2 - 0{,}5 = 0$ задаёт прямую на плоскости. Точка $(2, 3)$ даёт $z = 2 + 3 - 0{,}5 = 4{,}5 > 0$ — она лежит по одну сторону прямой и классифицируется как класс $+1$; точка $(0, 0)$ даёт $z = -0{,}5 < 0$ — класс $-1$. Расстояние от $(2, 3)$ до прямой равно $|4{,}5| / \sqrt{1^2+1^2} \approx 3{,}18$.
Интуиция: обучить перцептрон — значит подобрать нормаль $w$ и сдвиг $b$ так, чтобы гиперплоскость правильно разрезала пространство признаков. Вся остальная математика — правило обучения и теорема сходимости — это лишь способ систематически «крутить» гиперплоскость, пока она не встанет туда, куда нужно.
2.4. Линейная разделимость#
Раз перцептрон решает задачу гиперплоскостью, сразу возникает вопрос: а когда такая гиперплоскость вообще существует?
Определение. Множества точек (классы) называются линейно разделимыми, если существуют такой вектор весов $w$ и такое смещение $b$, что для всех обучающих примеров $x_i$ выполняется
$$ y_i (w^T x_i + b) > 0 \quad \forall i, $$где $y_i \in \{-1, +1\}$ — истинная метка класса $i$-го примера.
Разберём, что означает это неравенство. Если у точки метка $y_i = +1$, то требуется $w^T x_i + b > 0$ — точка должна лежать с «плюсовой» стороны гиперплоскости. Если $y_i = -1$, то требуется $w^T x_i + b < 0$ — точка должна лежать с противоположной стороны. Умножение на $y_i$ — это аккуратный способ записать оба требования одной формулой: произведение $y_i(w^T x_i + b)$ всегда должно быть строго положительным. Строгость неравенства означает, что не бывает точек, лежащих точно на границе, — в этом случае ответ модели был бы неопределённым.
Классические примеры. Булевы функции на двух бинарных входах $x_1, x_2 \in \{0, 1\}$ — удобная площадка для проверки разделимости.
- AND ($y = x_1 \land x_2$): точки разделимы. Можно провести прямую так, чтобы точка $(1,1)$ (ответ $1$) лежала по одну сторону, а точки $(0,0)$, $(0,1)$, $(1,0)$ (ответ $0$) — по другую. Например, прямая $x_1 + x_2 = 1{,}5$ отделяет $(1,1)$ от остальных.
- OR ($y = x_1 \lor x_2$): точки разделимы. Здесь уже три точки из четырёх имеют ответ $1$, и их можно отделить от единственной точки $(0,0)$, например прямой $x_1 + x_2 = 0{,}5$.
- NOT (отрицание одного входа): также разделима — это просто порог по единственному признаку.
- XOR ($y = x_1 \oplus x_2$, ответ $1$, когда входы различаются): не разделима. Точки с ответом $1$ — это $(0,1)$ и $(1,0)$ — стоят по диагонали, и никакая одна прямая не может отделить их от точек $(0,0)$ и $(1,1)$, которые тоже стоят по диагонали, но «крест-накрест». Любая прямая оставит в одной половине хотя бы по одной точке каждого класса.
Интуиция: линейная разделимость — это то, что перцептрон «умеет» и что он «не умеет». Пока классы можно разделить одной гиперплоскостью, однослойный перцептрон способен их выучить. Пример XOR показывает границу возможностей: для таких задач одной гиперплоскости мало — понадобятся скрытые слои, о чём речь пойдёт дальше в лекции.
2.5. Примеры на доске#
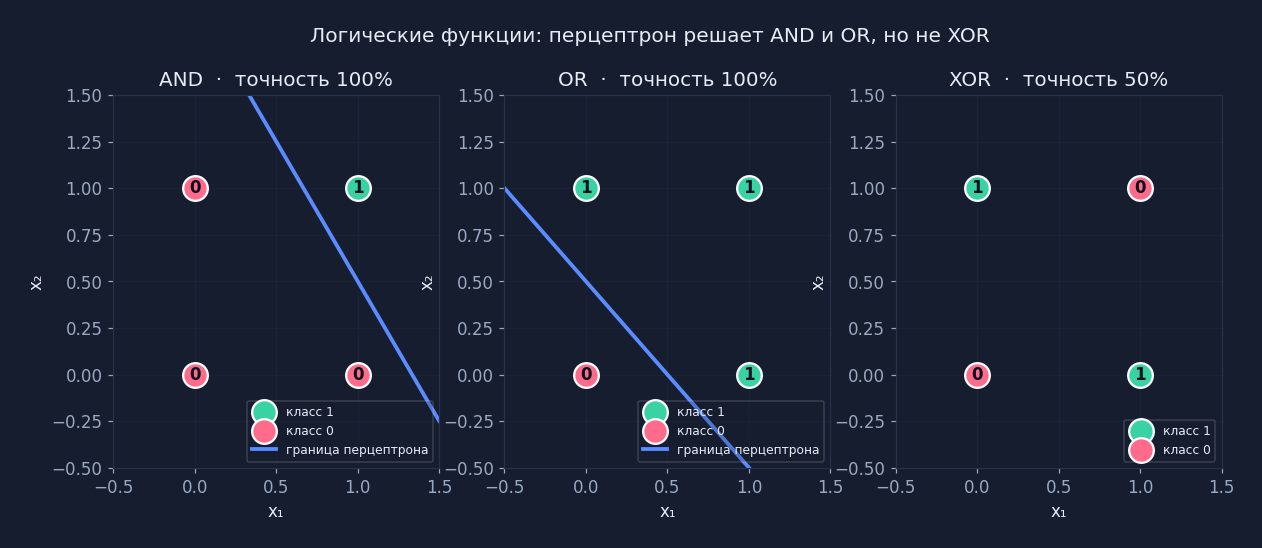
Исторически и методически эти примеры разбирают на доске — на них лучше всего видно и геометрию гиперплоскости, и границу возможностей перцептрона.
AND. Входы $x_1, x_2 \in \{0, 1\}$, целевой ответ $y = x_1 \land x_2$. На плоскости рисуем четыре точки единичного квадрата и подписываем ответы: у $(0,0)$, $(0,1)$, $(1,0)$ — $0$, у $(1,1)$ — $1$. Разделяющую прямую можно провести множеством способов — например, $x_1 + x_2 = 1{,}5$.
OR. Тот же квадрат, но $y = x_1 \lor x_2$: ответ $1$ у всех точек, кроме $(0,0)$. Прямая $x_1 + x_2 = 0{,}5$ отделяет «нулевую» точку от остальных.
XOR. Входы те же, но $y = x_1 \oplus x_2$: ответ $1$ у $(0,1)$ и $(1,0)$, ответ $0$ у $(0,0)$ и $(1,1)$. Сколько ни пробуй провести одну прямую, она не сможет разделить классы — единицы и нули «перемешаны» по диагоналям квадрата. Это и есть наглядная демонстрация невозможности решить XOR одной прямой, а значит — и одним однослойным перцептроном.
Практическое задание. Нарисуйте на бумаге (или в тетради) точки для AND, OR и XOR и попробуйте самостоятельно провести разделяющую прямую для каждого случая. Для AND и OR вы быстро найдёте подходящую прямую; для XOR убедитесь, что ни одна прямая не подходит. Это задание вырабатывает геометрическое чутьё: вы научитесь «на глаз» определять, линейно разделима задача или нет, — навык, который пригодится при анализе любых линейных моделей, от перцептрона до SVM.
Итог раздела: однослойный перцептрон — это линейная комбинация признаков $z = w^T x + b$, пропущенная через функцию активации $\hat y = \phi(z)$. Геометрически уравнение $w^T x + b = 0$ задаёт гиперплоскость с нормалью $w$, а классификация сводится к определению стороны, на которой лежит точка; расстояние до границы равно $|w^T x + b| / \|w\|$ и служит мерой уверенности. Классы линейно разделимы, если существует гиперплоскость со строгим разделением $y_i(w^T x_i + b) > 0$; AND, OR и NOT разделимы, а XOR — нет, что и демонстрирует принципиальное ограничение однослойного перцептрона и мотивирует переход к многослойным сетям.
3. Алгоритм обучения перцептрона#
Мы знаем, как устроена модель однослойного перцептрона: она проводит линейную границу $w^T x + b = 0$ и относит точку к одному из двух классов в зависимости от знака выражения $w^T x + b$. Но откуда берутся «правильные» веса $w$ и смещение $b$? Ответ даёт алгоритм обучения. В этом разделе мы разберём, как формально ставится задача обучения, выведем правило обновления весов, запишем его в виде псевдокода, обсудим практические варианты организации обучения — и, наконец, посмотрим на близкого родственника перцептрона — ADALINE, а также на связь обоих алгоритмов с логистической регрессией.
3.1. Постановка задачи#
Пусть у нас есть обучающая выборка
$$\{(x_i, y_i)\}_{i=1}^m, \qquad y_i \in \{-1, +1\},$$то есть $m$ примеров, каждый из которых описан вектором признаков $x_i$, а метка $y_i$ говорит, к какому из двух классов пример принадлежит. Метки $\{-1, +1\}$ удобны для перцептрона: знак выражения $w^T x + b$ естественно сопоставляется с классом точки.
Требуется найти такие параметры модели — вектор весов $w$ и смещение $b$, — которые правильно классифицируют все примеры обучающей выборки, то есть для каждого $i$ выполнялось бы $\operatorname{sign}(w^T x_i + b) = y_i$.
Разберём значок $\{(x_i, y_i)\}_{i=1}^m$ — он выглядит страшно, но означает простую вещь: «у нас стопка из $m$ карточек».
- $x_i$ — «признаки $i$-го объекта» (например, анализы $i$-го пациента).
- $y_i$ — «правильный ответ для него» (болен или здоров).
- $\{\dots\}_{i=1}^m$ — «таких пар от первой до $m$-й». Фигурные скобки — это просто «множество, список».
- $i$ — счётчик: $i = 1$ — первая карточка, $i = 2$ — вторая, и так до $m$.
- $y_i \in \{-1, +1\}$ — ответ бывает только двух видов: «$-1$» или «$+1$» (например, «нет/есть»).
Например, если пациентов трое, запись превращается просто в список: $(x_1, +1),\ (x_2, -1),\ (x_3, +1)$ — три пары «анализы + правильный ответ». И всё.
Ключевой факт, на котором строится весь классический анализ перцептрона: если данные линейно разделимы — то есть существует гиперплоскость, отделяющая один класс от другого, — то решение такой задачи существует, и алгоритм обучения, который мы рассмотрим ниже, гарантированно его найдёт за конечное число шагов.
Интуиция: задача обучения — это поиск параметров «на глазок», но не вслепую. Мы перебираем гипотезы о положении разделяющей прямой, опираясь на ошибки, которые модель совершает на известных примерах. Если данные в принципе разделимы, этот процесс сойдётся к правильной прямой.
3.2. Перцептронное правило#
Основная идея правила обучения перцептрона проста: меняем параметры только тогда, когда модель ошибается. Если очередной пример классифицирован верно — ничего не делаем. Если неверно — сдвигаем веса и смещение в сторону, которая исправляет ошибку:
$$w \leftarrow w + \eta\, y_i x_i,$$Читается: «новое w = старое w + шаг × правильный ответ × признаки». Ошибся — подтолкни границу, угадал — не трогай> $$b \leftarrow b + \eta\, y_i,$$
где $\eta > 0$ — скорость обучения (learning rate).
Стрелка $\leftarrow$ — это не «равно», а «стало». Читаем формулу вслух по шагам.
- $\eta$ (греческая «эта») — это просто «размер шага», маленькое число вроде $0{,}1$ или $0{,}01$. Чем больше $\eta$, тем резче модель дёргает веса за один раз.
- $y_i x_i$ — «куда двигаться». Если правильный ответ $y_i = +1$, это $+x_i$ (толкаем к точке), если $y_i = -1$ — $-x_i$ (толкаем от точки).
- $w \leftarrow w + \eta y_i x_i$: новое $w$ = старое $w$ плюс маленький шаг в нужную сторону.
Смысл на пальцах: ученик посмотрел на ошибку и чуть-чуть подвинул линию в правильную сторону. Угадал — не двигает вообще. То есть действует правило «нет ошибки — нет правки».
Конкретно: пусть $\eta = 0{,}1$, объект $x = (2, 1)$, а правильный класс $y_i = +1$, но модель ошиблась. Тогда прибавка к весам $\eta y_i x = 0{,}1 \cdot 1 \cdot (2,1) = (0{,}2,\ 0{,}1)$ — веса немного выросли именно в направлении этой точки, и в следующий раз линия пройдёт «правильнее».
Геометрический смысл. Пусть $y_i = +1$, а модель отнесла точку к классу $-1$ (ошибка). Тогда $y_i x_i = x_i$: мы прибавляем к $w$ сам вектор признаков, то есть «тянем» границу к ошибочной точке, чтобы в следующий раз она оказалась по правильную сторону. Если же $y_i = -1$, а модель ошиблась, то $y_i x_i = -x_i$: мы прибавляем вектор, направленный от точки, — граница отодвигается от неё. Смещение $b$ корректируется аналогично, сдвигая границу целиком.
Для случая, когда метки заданы как $\{0, 1\}$ (например, в варианте с порогом $\hat{y}_i \in \{0,1\}$), правило записывают в другой, но родственной форме:
$$w \leftarrow w + \eta\, (y_i - \hat{y}_i)\, x_i.$$Здесь $(y_i - \hat{y}_i)$ — «величина недовыполнения»: если модель ошиблась, разность между истинной меткой и предсказанной равна $\pm 1$, и веса сдвигаются в нужную сторону; если модель угадала, разность равна нулю и веса не меняются.
Интуиция: перцептрон — «жадный» ученик: он исправляется только по факту ошибки и не трогает параметры, когда всё уже хорошо. Это делает правило очень простым и дешёвым, но, как мы увидим далее, не всегда достаточно аккуратным.
3.3. Вывод правила через функцию потерь#
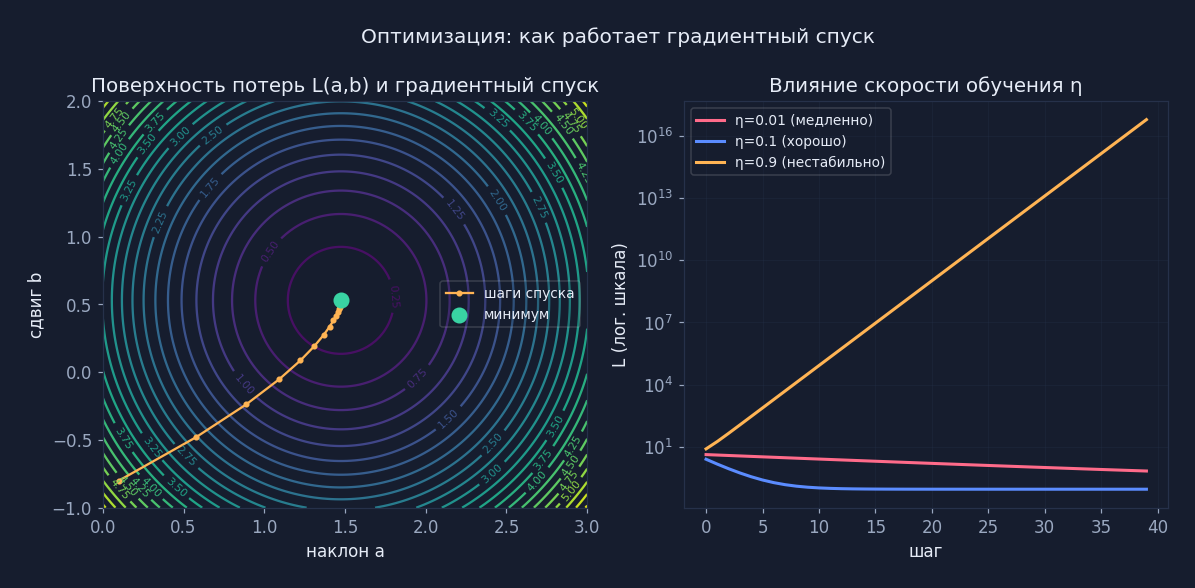
Правило обновления не взято с потолка — оно является шагом градиентного спуска по специально подобранной функции потерь. Рассмотрим множество $M$ примеров, на которых модель ошибается. Перцептронный критерий задаётся как сумма «штрафов» по ошибочным примерам:
$$L(w,b) = -\sum_{i \in M} y_i\, (w^T x_i + b).$$Читается: «штраф = сумма промахов по ошибочным примерам». Ошибок нет — штраф ноль>
Формула $L = -\sum_{i \in M} y_i (w^T x_i + b)$ — это «счётчик штрафа за ошибки». Разберём по частям.
- $M$ — это «список тех примеров, на которых модель сейчас ошибается». Не всех $m$ примеров, а только тех, где промах.
- $\sum_{i \in M}$ — «просуммируй по всем ошибочным примерам». Если ошибок нет, сумма пустая, и $L = 0$ — идеал.
- $y_i (w^T x_i + b)$ — «насколько уверенно и куда ошиблась модель». Вспомним: у ошибочного примера знак этой величины отрицательный (правильный класс и мнение модели не совпали).
- Минус спереди превращает это в положительное число-штраф: чем «увереннее» ошибка, тем больше штраф.
Мораль: $L$ — это «суммарная боль» модели. Обучение = уменьшать эту боль. В идеале $L = 0$, что бывает только когда ошибок нет.
Пример: один ошибочный пример дал $y_i (w^T x_i + b) = -3$. Тогда его штраф $-(-3) = 3$. Обучаемся — этот штраф уменьшается, и модель исправляется.
Почему это разумная потеря? Если пример классифицирован верно, то знак $y_i (w^T x_i + b)$ положителен (модель дала правильный знак), а если неверно — отрицателен. Брать такие примеры с минусом и суммировать означает: чем «увереннее» модель ошибается, тем больше штраф, и минимум потери достигается, когда ошибок нет вовсе — в этом случае $L = 0$.
Вычислим градиент. Поскольку в сумму входят только ошибочные примеры, производные берутся только по ним:
$$\nabla_w L = -\sum_{i \in M} y_i x_i, \qquad \frac{\partial L}{\partial b} = -\sum_{i \in M} y_i.$$Градиентный спуск двигает параметры против градиента: $w \leftarrow w - \eta \nabla_w L$ и $b \leftarrow b - \eta \frac{\partial L}{\partial b}$. Если применить этот шаг для одного ошибочного примера (стохастический вариант), получаем в точности перцептронное правило:
$$w \leftarrow w + \eta\, y_i x_i, \qquad b \leftarrow b + \eta\, y_i.$$Минус перед $\eta$ «съедается» знаком градиента, и обновление совпадает с уже знакомым нам видом.
Интуиция: перцептронное правило — это не «магия», а градиентный спуск по естественной потере: «штрафуем за каждую ошибку пропорционально её уверенности». Геометрически это ровно та же операция «притянуть границу к ошибочной точке», что мы описали выше, — только выведенная формально.
3.4. Псевдокод#
Соберём всё вместе в виде алгоритма. Для удобства вектор признаков можно дополнить единичной координатой, поглотив $b$ в $w$, но в явном виде псевдокод выглядит так:
инициализировать w, b (нулями или малыми случайными)

повторять эпохи:
    для каждого (x_i, y_i):
        z = w^T x_i + b
        y_hat = sign(z)
        если y_hat != y_i:
            w = w + eta * y_i * x_i
            b = b + eta * y_i
    если ошибок нет: остановиться
Здесь эпоха — это один полный проход по всем примерам обучающей выборки. Алгоритм останавливается, как только находит параметры, которые классифицируют все примеры без ошибок. Для линейно разделимых данных такая остановка гарантирована: теорема сходимости перцептрона утверждает, что при подходящей скорости обучения процесс завершится за конечное число шагов. Если же данные не разделимы (например, задача XOR), алгоритм не остановится и будет бесконечно «метаться» — граница никогда не станет идеальной.
3.5. Варианты обучения#
На практике обновление весов можно организовывать по-разному:
- Online (онлайн): обновление после каждого примера. Параметры меняются сразу после
предъявления очередного $(x_i, y_i)$. Это то, что записано в псевдокоде выше: самый простой и «живой» режим, хорошо работающий на потоках данных.
- Batch (пакетный): обновление после всей эпохи. Сначала накапливаются градиенты по всем
примерам, затем параметры меняются один раз. Шаг получается «усреднённым» и более устойчивым, но требует держать в памяти всю выборку.
- Mini-batch (мини-пакеты): компромисс между двумя крайностями. Выборка разбивается на
небольшие блоки (например, по 16–64 примера), и обновление выполняется после каждого блока. Так сочетаются скорость онлайн-режима и устойчивость пакетного. Именно этот режим стал стандартом в обучении современных нейросетей.
Кроме способа организации обновлений, на сходимость сильно влияют и другие практические детали:
- Влияние скорости обучения $\eta$: если $\eta$ слишком мала, обучение идёт медленно и
требует много эпох; если слишком велика — шаги становятся слишком большими, и алгоритм может «перепрыгивать» хорошее решение, становясь нестабильным (веса колеблются, не сходясь). $\eta$ — это гиперпараметр, который приходится подбирать.
- Инициализация: веса можно инициализировать нулями или малыми случайными значениями;
нулевая инициализация для перцептрона допустима, случайная — чуть «развязывает» обучение.
- Нормализация признаков: если признаки имеют сильно разный масштаб, градиенты по разным
координатам тоже различаются, и обучение замедляется; приведение признаков к одному масштабу (например, к нулевому среднему и единичной дисперсии) ускоряет сходимость.
- Порядок примеров: порядок, в котором примеры подаются в онлайн-режиме, влияет на траекторию
обучения; в частности, перемешивание выборки может помочь избежать «застревания» на коррелированных последовательностях примеров.
Интуиция: выбор варианта обучения — это всегда компромисс между скоростью обновлений (онлайн — быстрее реагирует, но шумнее) и точностью оценки градиента (пакет — точнее, но дороже). Мини-пакеты дают «золотую середину», поэтому они и победили на практике.
3.6. ADALINE и дельта-правило#
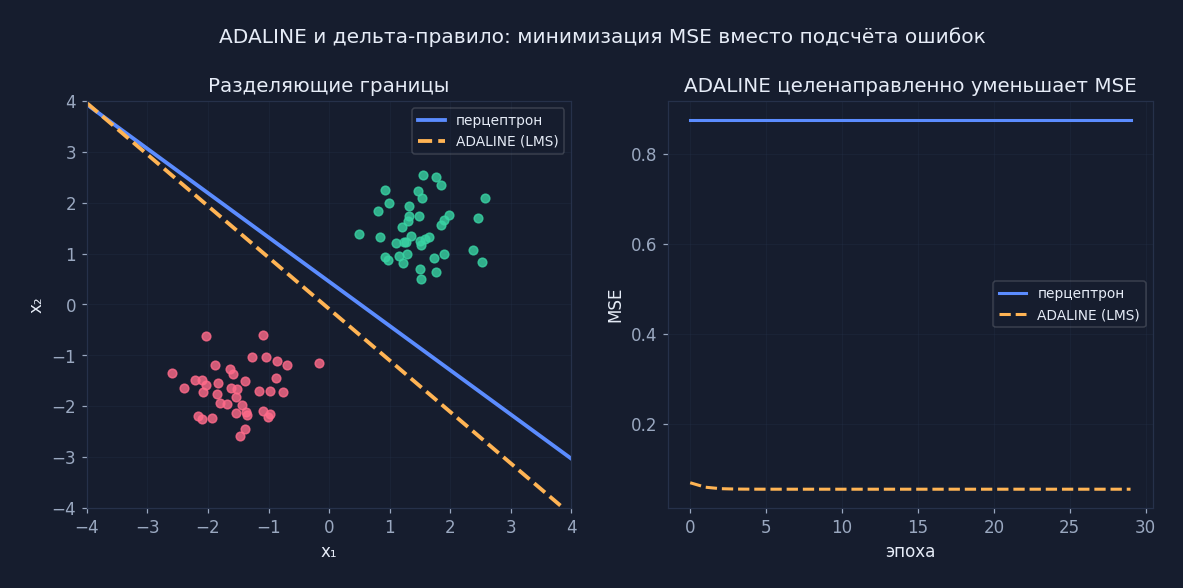
Прямой наследник перцептрона — модель ADALINE (Adaptive Linear Neuron). Её ключевое отличие в том, что выход линейный: $z = w^T x + b$, без знаковой нелинейности. Вместо перцептронного критерия используется среднеквадратичная ошибка (MSE):
$$L = \frac{1}{2}\sum_i (y_i - z_i)^2.$$Среднеквадратичная ошибка (MSE) — «как сильно модель промахнулась по величине».
- $y_i$ — правильный ответ, $z_i$ — то, что выдала модель (линейное число, без округления).
- $y_i - z_i$ — промах: если модель угадала точно, это ноль. Если занизила — отрицательное, завысила — положительное.
- $(y_i - z_i)^2$ — квадрат промаха. Зачем квадрат? Чтобы минус и плюс не гасили друг друга, и чтобы большие промахи «стоили дороже» маленьких (квадрат растёт быстро).
- $\frac{1}{2}$ спереди — косметика: при взятии производной двойка из квадрата сократится с этой половинкой, формулы станут чище.
- $\sum_i$ — складываем штрафы по всем примерам.
Отличие от перцептрона: там штрафовали только за факт ошибки (да/нет), а здесь — за точное числовое расхождение. Поэтому ADALINE учится аккуратнее и уменьшает ошибку даже на уже правильно классифицированных примерах.
Минимизируя эту потерю градиентным спуском, получаем дельта-правило (правило Уидроу–Хоффа):
$$w \leftarrow w + \eta\, (y_i - z_i)\, x_i.$$Отличие от перцептрона принципиальное: перцептрон обновляет веса только при неправильной классификации. ADALINE же обновляет веса даже при правильной классификации, если линейный выход $z_i$ далёк от метки $y_i$. Потеря MSE «наказывает» модель за любую неточность величины выхода, а не только за неверный знак. Благодаря гладкой квадратичной потере ADALINE обучается более «плавно» и допускает аккуратный градиентный анализ.
Наконец, есть и следующая ступень эволюции: связь с логистической регрессией. Если заменить в ADALINE линейный выход на сигмоиду $\sigma(z) = 1/(1+e^{-z})$, а MSE — на кросс-энтропийную потерю, мы получим логистическую регрессию — вероятностную модель классификации, у которой выход интерпретируется как вероятность принадлежности к классу. Так выстраивается непрерывная линия: перцептрон (знак, обновление по ошибкам) → ADALINE (линейный выход, MSE) → логистическая регрессия (сигмоида, кросс-энтропия) → современные нейросети.
Демонстрация: на практике весь этот материал обычно закрепляется так — берут линейно разделимые двумерные данные, обучают на них перцептрон с нуля (например, на Python/NumPy) и визуализируют: как с каждой эпохой разделяющая прямая поворачивается и сдвигается, пока не разделит классы без ошибок. Именно эта картинка — «граница учится» — лучше всего даёт понять, что делает описанный выше алгоритм.
Итог раздела: обучение перцептрона — это итеративный процесс коррекции весов по ошибочным примерам, который формально является стохастическим градиентным спуском по перцептронному критерию. Для линейно разделимых данных алгоритм гарантированно сходится, причём организация обучения (онлайн, пакет, мини-пакеты) и настройка скорости обучения $\eta$ определяют, насколько быстро и устойчиво это произойдёт. Более аккуратный родственный алгоритм ADALINE обучается по дельта-правилу, минимизируя среднеквадратичную ошибку и корректируя веса даже при верной классификации, а логистическая регрессия продолжает ту же линию, добавляя сигмоиду и кросс-энтропийную потерю.
4. Теоретическое обоснование#
В этом разделе мы отойдём от алгоритмических деталей и посмотрим на перцептрон с теоретической высоты: что гарантировано, где границы применимости, как измерять сложность модели и почему однослойный перцептрон не всемогущ.
4.1. Теорема сходимости перцептрона#
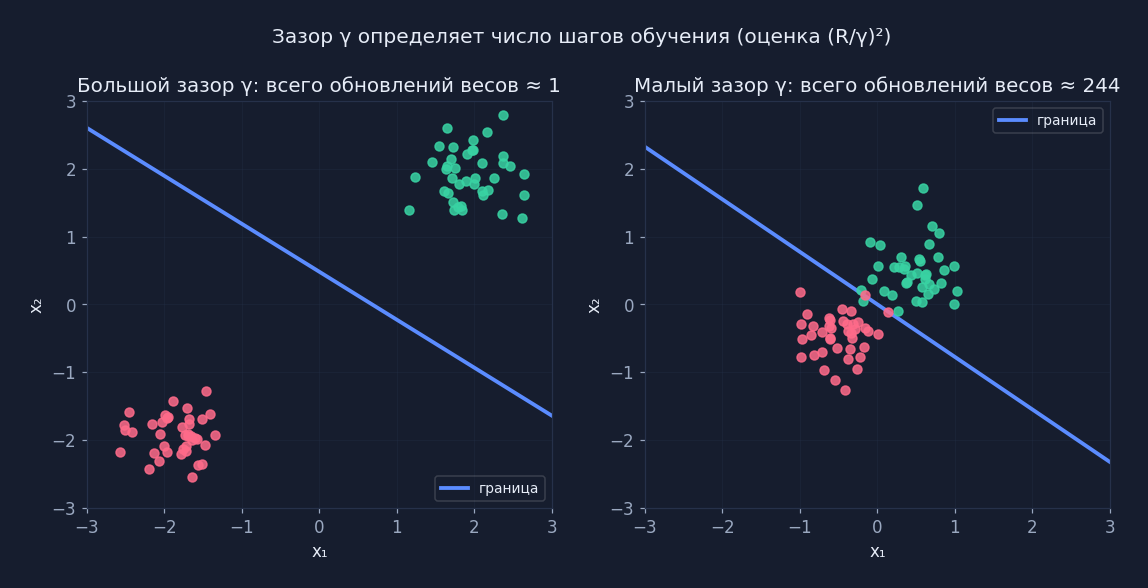
Формулировка. Пусть обучающая выборка $\{(x_i, y_i)\}_{i=1}^m$ линейно разделима с зазором $\gamma > 0$, и пусть все объекты ограничены по норме: $\|x_i\| \le R$. Тогда алгоритм перцептрона совершит не более
$$ \left(\frac{R}{\gamma}\right)^2 $$Читается: «число ошибок не больше (размер данных / ширина зазора) в квадрате» — узкий зазор = долгая учёба>
ошибок (с точностью до константы, зависящей от темпа обучения $\eta$).
Вся теорема — это одна фраза: «число ошибок не превысит $(R/\gamma)^2$». Разберём, кто тут кто.
- $R$ — «радиус», самый большой размер объектов. Если все точки лежат в круге радиуса $R$ — это оно.
- $\gamma$ («гамма») — зазор, ширина «коридора» между классами. Чем больше $\gamma$, тем свободнее разделены классы.
- $R/\gamma$ — отношение «размер данных / ширина зазора». Своего рода «сложность задачи».
- $(R/\gamma)^2$ — квадрат этого отношения. Итоговое число ошибок сверху.
Смысл: узкий коридор (маленькая $\gamma$) — больших хлопот (много ошибок). Широкий коридор — учимся быстро. Это не точное число шагов, а гарантия «потолка»: больше — не будет.
Пример: $R = 1$, $\gamma = 0{,}5$. Тогда потолок ошибок $= (1/0{,}5)^2 = 4$. То есть уже за 4 ошибки перцептрон гарантированно всему выучится.
Интуиция: Теорема говорит: если данные можно разделить прямой (плоскостью) и между классами есть хоть какой-то «буфер» — пусть даже крошечный, — то перцептрон не будет бесконечно ошибаться. Количество ошибок ограничено сверху квадратом отношения радиуса данных к ширине зазора. Чем уже «коридор» между классами, тем дольше придётся учиться.
Схема доказательства. Доказательство элегантно и геометрично. Проведём его по шагам.
- Идеальный разделитель. Пусть $w^*$ — единичный вектор нормали к разделяющей гиперплоскости: $\|w^*\| = 1$. По условию линейной разделимости с зазором для любого объекта $x_i$ выполнено
То есть каждый объект лежит не ближе $\gamma$ от разделяющей плоскости.
- Правило обновления. Напомним: если перцептрон ошибся на объекте $(x_i, y_i)$, веса обновляются по правилу
где $k$ — номер ошибки (не номер эпохи, а счётчик сделанных ошибок).
- Рост проекции на идеальный вектор. Умножим обе части скалярно на $w^*$:
После $k$ ошибок имеем
$$ w_k^T w^* \ge k \eta \gamma. $$Проекция текущего вектора весов на идеальное направление растёт линейно с числом ошибок.
- Рост нормы весов — не быстрее корня. Оценим квадрат нормы:
Поскольку ошибка означает $y_i (w_k^T x_i) \le 0$, среднее слагаемое неположительно. Отбрасывая его, получаем
$$ \|w_{k+1}\|^2 \le \|w_k\|^2 + \eta^2 R^2. $$Отсюда по индукции
$$ \|w_k\| \le \eta R \sqrt{k}. $$Этот шаг говорит: «длина весов растёт не быстрее корня из числа ошибок». Если запутались — вот в чём фокус.
- Каждая ошибка обновляет $w$ и может его немного удлинить, но не сильно: прирост квадрата длины ограничен сверху величиной $\eta^2 R^2$ за раз.
- Сложив такой прирост $k$ раз, получаем, что квадрат длины $\|w_k\|^2$ вырос не больше чем на $k \eta^2 R^2$.
- Извлекая корень: $\|w_k\|$ не больше $\eta R \sqrt{k}$ (корень потому, что мы извлекли его из квадрата).
Зачем это нужно: с одной стороны веса «вытягиваются» в правильную сторону (проекция на идеальный вектор растёт линейно по $k$), а с другой — их полная длина растёт лишь как $\sqrt{k}$. Вместе эти две оценки зажмут $k$ и дадут конечный потолок.
- Стыковка через Коши–Буняковского. С одной стороны, $w_k^T w^* \ge k \eta \gamma$. С другой — по неравенству Коши–Буняковского
Объединяем:
$$ k \eta \gamma \le \eta R \sqrt{k} \quad\Longrightarrow\quad k \le \left(\frac{R}{\gamma}\right)^2. $$Число ошибок $k$ ограничено — сходимость доказана.
Итог раздела: Теорема сходимости гарантирует, что при линейной разделимости перцептрон сделает не более $(R/\gamma)^2$ ошибок. Доказательство опирается на два ключевых неравенства: проекция на идеальный разделитель растёт линейно, а норма весов — не быстрее квадратного корня. Стыковка через Коши–Буняковского даёт конечную верхнюю границу.
4.2. Что гарантирует и что не гарантирует теорема#
Теорема сходимости — сильный результат, но у него есть важные ограничения.
Что теорема гарантирует:
- Сходимость за конечное число шагов. Если данные линейно разделимы, перцептрон обязательно остановится (перестанет ошибаться) — и сделает это не более чем за $(R/\gamma)^2$ ошибок.
- Существование верхней границы, зависящей только от геометрии данных ($R$ и $\gamma$), а не от числа признаков или размера выборки.
Что теорема НЕ гарантирует:
- Хорошее обобщение. Сходимость к разделяющей плоскости не означает, что эта плоскость будет правильно классифицировать новые, не виденные ранее объекты. Перцептрон может «впритык» разделить выборку, но на новых данных ошибаться.
- Работу при отсутствии линейной разделимости. Если классы пересекаются (например, из-за шума), теорема неприменима. Алгоритм может бесконечно «прыгать» — веса не сойдутся.
- Скорость не зависит от темпа обучения $\eta$? С точностью до константы — да, но при слишком большом $\eta$ алгоритм может расходиться, при слишком малом — сходиться медленно. На практике $\eta$ выбирают небольшим (например, 0.1–1).
Интуиция: Представьте, что вы завязываете шнурки. Теорема говорит: «Если шнурки не запутаны, вы гарантированно завяжете их за конечное число попыток». Но она не обещает, что бантик будет красивым (обобщение) и не работает, если шнурки в узел спутаны (нелинейная разделимость).
Итог раздела: Теорема сходимости — это гарантия останова, а не гарантия качества. Она даёт уверенность, что алгоритм не зациклится на линейно разделимых данных, но не защищает от переобучения и не работает на неразделимых выборках.
4.3. Проблема XOR#
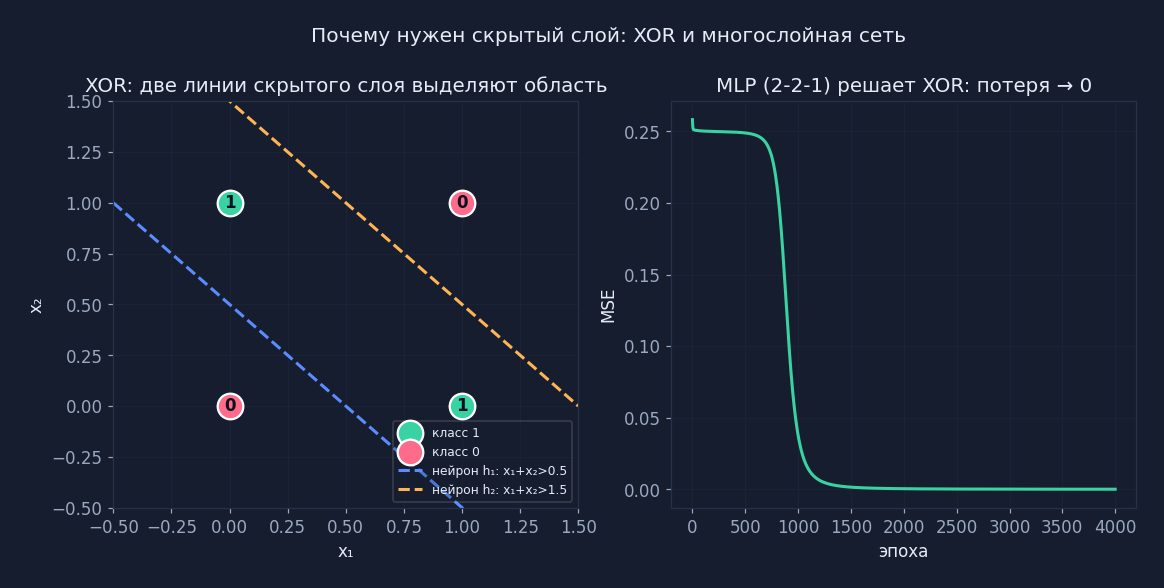
Простейший пример, который ломает однослойный перцептрон, — логическая функция XOR (исключающее «ИЛИ»).
Постановка. Рассмотрим четыре точки на плоскости:
- $(0,0)$ — класс $-1$,
- $(1,1)$ — класс $-1$,
- $(0,1)$ — класс $+1$,
- $(1,0)$ — класс $+1$.
Нужно разделить их одной прямой.
Доказательство неразделимости от противного. Предположим, что такая прямая существует. Тогда найдутся веса $w_1, w_2$ и смещение $b$, такие что
$$ y_i\,(w_1 x_{i1} + w_2 x_{i2} + b) > 0 \quad \text{для всех } i. $$Распишем для каждой точки:
- Для $(0,0)$ с $y=-1$: $-(b) > 0 \;\Rightarrow\; b < 0$.
- Для $(1,1)$ с $y=-1$: $-(w_1 + w_2 + b) > 0 \;\Rightarrow\; w_1 + w_2 + b < 0$.
- Для $(0,1)$ с $y=+1$: $w_2 + b > 0$.
- Для $(1,0)$ с $y=+1$: $w_1 + b > 0$.
Сложим неравенства (3) и (4): $(w_1 + b) + (w_2 + b) > 0$, то есть $w_1 + w_2 + 2b > 0$.
Но из (2) имеем $w_1 + w_2 + b < 0$. Вычтем: $(w_1 + w_2 + 2b) - (w_1 + w_2 + b) = b > 0$. Получаем $b > 0$, что противоречит (1): $b < 0$.
Противоречие. Значит, прямой, разделяющей XOR, не существует.
Интуиция: Попробуйте провести прямую на квадрате $[0,1]\times[0,1]$ так, чтобы точки одного цвета оказались по одну сторону, другого — по другую. У вас не получится: как ни крути линию, точки $(0,0)$ и $(1,1)$ всегда будут по разные стороны от точек $(0,1)$ и $(1,0)$.
Историческое значение. В 1969 году Минский и Паперт опубликовали книгу «Перцептроны», где показали ограничения однослойных моделей, включая неспособность решить XOR. Это вызвало охлаждение интереса к нейросетям — так называемую «первую зиму ИИ». Потребовалось введение скрытых слоёв с нелинейными функциями активации (многослойный перцептрон, MLP), чтобы преодолеть это ограничение.
Итог раздела: XOR — классический контрпример, показывающий, что однослойный перцептрон не может разделить нелинейно разделимые данные. Доказательство от противного даёт строгое обоснование: никакая прямая не разделит четыре точки XOR. Решение — добавить скрытый слой с нелинейностью.
4.4. Ёмкость, VC-размерность, обобщение#
Когда модель слишком сложна для имеющихся данных, она запоминает шум вместо закономерности. Чтобы это контролировать, нужны понятия ёмкости и VC-размерности.
VC-размерность перцептрона. Для перцептрона в пространстве $\mathbb{R}^n$ VC-размерность равна $n+1$. То есть перцептрон может разделить любую конфигурацию из $n+1$ точки в общем положении, но для $n+2$ точек это уже не гарантируется.
Интуиция: На плоскости ($n=2$) VC-размерность равна 3. Это значит, что три точки в общем положении (не на одной прямой) можно разделить прямой как угодно, а четыре — уже нет (вспомните XOR).
VC-размерность как мера сложности. Чем выше VC-размерность, тем богаче класс решающих правил, тем больше различных разбиений выборки модель может реализовать. Это напрямую связано с переобучением: если ёмкость модели велика, а данных мало, модель может идеально разделить выборку, но на новых данных покажет низкое качество.
Связь с обобщением. Теоретически, для хорошего обобщения размер выборки должен быть пропорционален VC-размерности (с точностью до логарифмических множителей). Эмпирическое правило: на каждый параметр модели нужно хотя бы 5–10 примеров.
Инструменты контроля переобучения:
- Регуляризация — добавление штрафа за величину весов (L2-регуляризация: $\lambda \|w\|^2$ в функцию потерь). Это заставляет модель выбирать «более простые» разделяющие плоскости с меньшей нормой весов.
- Валидация — отложенная выборка для контроля качества на невиданных данных. Если качество на валидации перестало расти — пора остановиться.
- Early stopping — остановка обучения до того, как модель начнёт переобучаться. На практике часто работает не хуже регуляризации.
Пример: Представьте, что вы подбираете полином к точкам на плоскости. Полином первой степени (прямая) — низкая ёмкость, может недобучаться. Полином десятой степени — высокая ёмкость, пройдёт через все точки, но между ними будет дико осциллировать. Регуляризация — это как «штраф за извилистость»: мы разрешаем полиному быть не слишком сложным.
Итог раздела: VC-размерность перцептрона в $\mathbb{R}^n$ равна $n+1$ — это мера его ёмкости. Чем выше ёмкость, тем больше риск переобучения. Регуляризация, валидация и early stopping — базовые приёмы, позволяющие удержать обобщающую способность модели под контролем.
Мини-упражнение#
Закрепим раздел двумя самостоятельными заданиями.
- Доказать, что XOR неразделим. Проведите доказательство от противного из раздела 4.3 самостоятельно, закрыв текст: предположите, что существует прямая $w_1 x_1 + w_2 x_2 + b = 0$, корректно разделяющая четыре точки XOR, выпишите неравенства для всех четырёх точек и доведите рассуждение до противоречия ($b < 0$ и $b > 0$ одновременно). Проследите, чтобы каждый шаг был строго обоснован: откуда берётся каждое неравенство и почему их комбинация невозможна.
- Построить контрпример для неразделимых данных. Придумайте набор точек на плоскости, который невозможно разделить одной прямой. Самый простой путь — модифицировать XOR: например, добавить к четырём точкам XOR пятую точку так, чтобы она «сломала» любую попытку провести разделяющую прямую (лежала бы с неверной стороны для любого кандидата). Проверьте своё решение: для каждого предположенного разделителя укажите конкретный объект, который он классифицирует неверно. Это упражнение наглядно показывает, почему теорема сходимости требует линейной разделимости: при её отсутствии разделяющей прямой просто не существует.
Итог раздела: Теоретическое обоснование даёт нам три опоры. Во-первых, теорема сходимости гарантирует: на линейно разделимых данных перцептрон остановится не более чем за $(R/\gamma)^2$ ошибок, хотя и не обещает хорошего обобщения. Во-вторых, XOR демонстрирует принципиальную границу однослойных моделей, преодолимую только скрытыми слоями с нелинейностью. В-третьих, VC-размерность и инструменты контроля (регуляризация, валидация, early stopping) объясняют, как удерживать баланс между ёмкостью модели и её способностью обобщать.
5. Расширения и связь с современным ML#
Друзья, мы прошли путь от одного нейрона до понимания того, как он учится. Теперь давайте посмотрим, куда эта дорога ведёт. Перцептрон — это не музейный экспонат, а фундамент, на котором построено всё современное машинное обучение. В этом блоке мы расширим наш арсенал: научимся классифицировать не два, а много классов, добавим вероятностную интерпретацию, прикрутим регуляризацию, заглянем в глубину нейросетей и разберёмся, как вообще оценивать качество моделей.
5.1. Многоклассовая классификация#
До сих пор наш перцептрон отвечал на вопрос «да/нет»: объект относится к классу $+1$ или $-1$. А если классов десять? Или сто? Нужно обобщение.
One-vs-All (OvA)#
Идея простая: обучим $K$ отдельных бинарных классификаторов, где $K$ — число классов. Для $k$-го классификатора будем считать класс $k$ положительным ($y=+1$), а все остальные — отрицательными ($y=-1$). На практике это выглядит так:
- Обучаем перцептрон (или логистическую регрессию) для класса «кошка» против всех остальных.
- Обучаем для класса «собака» против всех остальных.
- И так для каждого класса.
На предсказании подаём объект на вход всем $K$ моделям, получаем $K$ «сырых» ответов $z_k = w_k^T x + b_k$ и выбираем класс с максимальным значением:
$$ \hat{y} = \arg\max_{k} z_k $$Интуиция. Представьте, что вы эксперт, который должен отличить яблоки от груш и апельсинов. Вы можете натренировать три рефлекса: «это яблоко или нет?», «это груша или нет?», «это апельсин или нет?». Для каждого объекта вы запускаете все три рефлекса и выбираете тот, который сработал увереннее всего.
Пример. Распознавание цифр (MNIST, 10 классов). Обучаем 10 перцептронов. Для цифры «3» все тройки — положительный класс, всё остальное — отрицательный. На тесте объект, похожий на тройку, даст высокий $z_3$ и низкие остальные $z_k$ — побеждает тройка.
Плюсы: простота, $K$ моделей вместо $K(K-1)/2$. Минусы: дисбаланс классов (положительных примеров одного класса в $K$ раз меньше, чем отрицательных), и классификаторы могут быть неуверенными в зонах пересечения классов.
One-vs-One (OvO)#
Альтернативный подход: обучить бинарный классификатор для каждой пары классов. Для $K$ классов это $C(K,2) = K(K-1)/2$ моделей. Каждая модель решает задачу «класс $i$ против класса $j$». На предсказании запускаем все пары, и каждый классификатор «голосует» за один из двух классов. Побеждает класс, набравший больше всего голосов.
Интуиция. Вместо того чтобы учиться отличать яблоко от всего мира сразу, вы учитесь отличать яблоко от груши, яблоко от апельсина, грушу от апельсина. Потом на спор яблоко vs груша — победило яблоко, яблоко vs апельсин — победило яблоко, груша vs апельсин — победила груша. Итог: у яблока 2 голоса, у груши 1 — побеждает яблоко.
Плюсы: каждая модель обучается на сбалансированной выборке (примеров двух классов поровну). Минусы: $O(K^2)$ моделей — при $K=100$ это 4950 классификаторов, что может быть дорого.
Softmax — вероятностный подход#
Самый элегантный способ. Вместо того чтобы обучать $K$ отдельных моделей, мы обучаем одну с $K$ выходами. Пусть $z_k = w_k^T x + b_k$ — «сырой» выход для класса $k$. Функция softmax превращает эти $K$ чисел в вероятности:
$$ p(y = k \mid x) = \frac{e^{z_k}}{\sum_{j=1}^{K} e^{z_j}} $$Свойства:
- Все $p(y=k|x) \in (0,1)$.
- $\sum_{k=1}^{K} p(y=k|x) = 1$ — полная группа событий.
- Если $z_k \gg z_j$ для всех $j \neq k$, то $p(y=k|x) \approx 1$ — модель уверена.
- Если все $z_k$ примерно равны, вероятности близки к $1/K$ — модель не уверена.
Интуиция. Экспонента «усиливает» разницу: чуть больший $z_k$ даёт существенно большую вероятность. Это как конкурс талантов: судьи ставят оценки, и зрители аплодируют громче тому, кто набрал больше баллов, — но аплодисменты нормируются так, чтобы сумма всех аплодисментов была 100%.
Пример. Для цифры «3»: $z = [0.5, 1.2, -0.3, 5.1, 0.8, -0.1, 0.3, 0.9, -0.5, 0.2]$. После softmax: $p \approx [0.006, 0.013, 0.003, 0.63, 0.009, 0.003, 0.005, 0.010, 0.002, 0.005]$ — модель с вероятностью 63% говорит, что это тройка.
Softmax — стандартный выбор для многоклассовой классификации в современных нейросетях. Функция потерь — кросс-энтропия (о ней ниже).
5.2. Логистическая регрессия#
Перцептрон выдаёт жёсткое решение: $+1$ или $-1$. А что, если мы хотим не только ответ, но и уверенность в нём? Тут на сцену выходит логистическая регрессия.
От ступеньки к сигмоиде#
В перцептроне функция активации — ступенька (sign): $\hat{y} = \text{sign}(w^T x + b)$. В логистической регрессии мы заменяем её на сигмоиду:
$$ \sigma(z) = \frac{1}{1 + e^{-z}} $$Сигмоида принимает значения от 0 до 1 и имеет S-образную форму. $\sigma(0) = 0.5$, при $z \to +\infty$ $\sigma(z) \to 1$, при $z \to -\infty$ $\sigma(z) \to 0$.
Интуиция. Сигмоида — это «мягкая» ступенька. Она говорит не просто «да/нет», а «я думаю, да с вероятностью 73%». Чем дальше объект от разделяющей гиперплоскости, тем увереннее модель.
Функция потерь: бинарная кросс-энтропия#
Для перцептрона мы использовали кусочно-линейную потерю (количество ошибок). Для логистической регрессии — бинарную кросс-энтропию (log-loss):
$$ L(y, \hat{p}) = -y \ln \hat{p} - (1 - y) \ln(1 - \hat{p}) $$где $y \in \{0, 1\}$ — истинная метка, $\hat{p} = \sigma(w^T x + b)$ — предсказанная вероятность класса $1$.
Формула выглядит громоздко, но внутри — простая идея «накажи за уверенную ошибку».
- $\ln$ — натуральный логарифм (значок «$\ln$» — как «$\log$» по основанию $e$). Он очень быстро уходит в минус бесконечность у нуля.
- Обратите внимание: формула разделена на два слагаемых, и всегда работает только одно из них, потому что $y$ — это либо $0$, либо $1$.
Если истинный класс $y = 1$: второе слагаемое умножается на $(1-1)=0$ и исчезает, остаётся $L = -\ln \hat{p}$.
- Модель сказала $\hat{p} = 0{,}99$ (уверена в классе 1, и это верно) → $L = -\ln 0{,}99 \approx 0{,}01$ — штраф почти ноль, всё отлично.
- Модель сказала $\hat{p} = 0{,}01$ (уверена в классе 0, а истина — 1) → $L = -\ln 0{,}01 \approx 4{,}6$ — большой штраф.
- Модель сказала $\hat{p} = 0{,}5$ (не знает) → $L = -\ln 0{,}5 \approx 0{,}69$ — средний штраф.
Если истинный класс $y = 0$ — зеркально то же самое. Логика одна: чем увереннее ошибаешься, тем больнее. Логарифм здесь — это «дубина для самоуверенных промахов».
Интуиция. Если истинный класс $y=1$, то $L = -\ln \hat{p}$. Чем ближе $\hat{p}$ к 1, тем меньше loss. Если $\hat{p}=0.01$ (модель почти уверена, что это класс 0, а на самом деле класс 1), loss огромный ($-\ln 0.01 \approx 4.6$). Аналогично для $y=0$. Штраф за уверенную ошибку — суровый.
Градиент#
Красота логистической регрессии в том, что градиент имеет очень простой вид:
$$ \nabla_w L = (\sigma(w^T x + b) - y) \cdot x $$То есть градиент = (ошибка предсказания) × (вход). Если модель ошиблась сильно ($\sigma \approx 1$, а $y=0$), ошибка большая — шаг большой. Если модель права ($\sigma \approx y$), ошибка близка к нулю — шаг маленький.
Обновление весов по SGD:
$$ w \leftarrow w - \eta \, (\sigma(w^T x + b) - y) \, x $$Сравните с правилом перцептрона: $w \leftarrow w + \eta (y - \hat{y}) x$. Разница в том, что в перцептроне $\hat{y} \in \{-1, +1\}$ (жёсткое), а в логистической регрессии $\sigma \in (0,1)$ (мягкое). Перцептрон — это «жёсткая» версия логистической регрессии: если заменить сигмоиду на ступеньку, получим перцептрон.
Пример. Пусть $x = [2, -1]$, $y=1$, $w=[0.5, 0.3]$, $b=0$. $z = 0.5\cdot2 + 0.3\cdot(-1) + 0 = 0.7$. $\sigma(0.7) = 0.668$. Ошибка: $0.668 - 1 = -0.332$. Градиент: $(-0.332) \cdot [2, -1] = [-0.664, 0.332]$. Обновление: $w_1 \leftarrow 0.5 - \eta(-0.664) = 0.5 + 0.664\eta$, $w_2 \leftarrow 0.3 - \eta(0.332) = 0.3 - 0.332\eta$. Веса сдвигаются так, чтобы в следующий раз $z$ был больше.
5.3. Регуляризация#
Когда модель слишком сложная, она может переобучиться — выучить шум в данных вместо закономерности. Регуляризация — это способ сказать модели: «будь проще, не выпендривайся».
L2-регуляризация (Ridge)#
Добавляем к функции потерь квадрат нормы весов:
$$ L_{\text{total}} = L + \frac{\lambda}{2} \|w\|^2 = L + \frac{\lambda}{2} \sum_{i=1}^{n} w_i^2 $$где $\lambda > 0$ — коэффициент регуляризации.
L2-регуляризация — это «штраф за большие веса».
- $L$ — обычная потеря (та же кросс-энтропия или MSE).
- $\frac{\lambda}{2} \sum w_i^2$ — добавка: сумма квадратов всех весов, умноженная на «силу штрафа» $\lambda$.
- $\lambda$ (греческая «лямбда») — ручка громкости штрафа. $\lambda = 0$ — регуляризации нет; большой $\lambda$ — веса жёстко придавливаются к нулю.
- Почему квадраты? Чтобы знаки не сокращались и чтобы штраф был гладким (удобным для градиента).
Смысл: модель старается не только ошибаться меньше, но и держать веса маленькими. Маленькие веса = проще граница = меньше шанс подогнаться под шум (переобучиться). Это как «не делать резких движений».
Здесь $\|w\|^2 = \sum_{i=1}^n w_i^2$ — квадрат длины вектора весов, то есть сумма квадратов его координат.
Градиент с L2:
$$ \nabla_w L_{\text{total}} = \nabla_w L + \lambda w $$Шаг SGD:
$$ w \leftarrow w - \eta (\nabla_w L + \lambda w) = (1 - \eta\lambda) w - \eta \nabla_w L $$Видите? Перед обновлением веса умножаются на $(1 - \eta\lambda) < 1$. Это «затухание» весов (weight decay). Каждый шаг веса чуть-чуть уменьшаются, если только градиент не тянет их вверх.
Интуиция. Представьте, что вы рисуете график по точкам. Без регуляризации вы можете нарисовать причудливую кривую, проходящую через каждую точку. С L2 вас штрафуют за «размах» кривой — она должна быть плавной. $\lambda$ — это жёсткость линейки: чем больше $\lambda$, тем прямее линия.
Пример. В линейной регрессии без регуляризации веса могут стать огромными, если признаки скоррелированы. L2 «стягивает» их к нулю, делая модель устойчивее.
L1-регуляризация (Lasso)#
Добавляем сумму модулей весов:
$$ L_{\text{total}} = L + \lambda \|w\|_1 = L + \lambda \sum_{i=1}^{n} |w_i| $$Градиент (субградиент) для L1: $\frac{\partial}{\partial w_i} \lambda |w_i| = \lambda \cdot \text{sign}(w_i)$.
Интуиция. L1 «разреживает» веса: многие из них становятся ровно нулём. Это встроенный отбор признаков. Если L2 — это «сделай все веса маленькими», то L1 — «сделай ненужные веса нулевыми».
Пример. У вас 1000 признаков, но только 10 реально важны. L1-регуляризация занулит 990 неважных весов, оставив только значимые. L2 сделает все веса маленькими, но нулевыми не сделает.
Зачем это всё?#
- Борьба с переобучением. Модель с огромными весами слишком чувствительна к малым изменениям входа.
- Устойчивость. Маленькие веса = маленькое изменение выхода при малом возмущении входа.
- Интерпретируемость (L1). Можно сказать: «из 100 признаков работают только 5».
5.4. От перцептрона к глубокому обучению#
Однослойный перцептрон не может решить проблему XOR — это его фатальный недостаток. Решение? Добавить скрытый слой.
Скрытый слой#
Вместо одного преобразования $x \to \hat{y}$ делаем два:
$$ h = \phi(W_1 x + b_1), \quad \hat{y} = \phi(W_2 h + b_2) $$где $\phi$ — нелинейная функция активации (сигмоида, tanh, ReLU), $W_1$ — матрица весов от входа к скрытому слою, $W_2$ — от скрытого слоя к выходу.
Интуиция. Скрытый слой — это «переосмысление» признаков. Перцептрон на входе видит «сырые» координаты $x_1, x_2$. Скрытый слой учится конструировать новые, более абстрактные признаки $h_1, h_2, \dots, h_m$, на которых задача XOR становится линейно разделимой.
Пример XOR. Два входа, один скрытый слой из 2 нейронов, выходной нейрон. Скрытый слой может выучить представление: $h_1 = \text{ReLU}(x_1 + x_2 - 0.5)$ (срабатывает, когда хотя бы один вход включён), $h_2 = \text{ReLU}(-x_1 - x_2 + 1.5)$ (срабатывает, когда хотя бы один выключен). Выходной слой на этих $h$ легко разделяет XOR.
Backpropagation — обобщение дельта-правила#
Для однослойного перцептрона мы обновляли веса по правилу: $w \leftarrow w + \eta (y - \hat{y}) x$. Для многослойной сети нужно обновлять веса и в скрытых слоях. Backpropagation (обратное распространение ошибки) — это просто цепное правило дифференцирования, применённое к графу вычислений.
Алгоритм в двух словах:
- Прямой проход (forward): вычисляем $h = \phi(W_1 x + b_1)$, затем $\hat{y} = \phi(W_2 h + b_2)$.
- Обратный проход (backward): считаем градиент loss по $W_2$ (как в перцептроне), затем «проталкиваем» ошибку назад к $W_1$ через цепное правило.
- Обновление: $W_1 \leftarrow W_1 - \eta \nabla_{W_1} L$, $W_2 \leftarrow W_2 - \eta \nabla_{W_2} L$.
Интуиция. Ошибка на выходе — это «вина» всех нейронов, которые к ней привели. Мы распределяем вину пропорционально их вкладу. Нейроны, которые сильно повлияли на ошибочный ответ, получают большее обновление. Это как в команде: если проект провалился, каждый получает выговор пропорционально своей ответственности.
Современные детали: ReLU, Dropout, Batch Normalization#
ReLU (Rectified Linear Unit):
$$ \text{ReLU}(z) = \max(0, z) $$Почему не сигмоида? У сигмоиды есть проблема исчезающего градиента: при больших $|z|$ производная близка к нулю, и сеть перестаёт учиться. ReLU имеет производную 1 при $z > 0$ и 0 при $z < 0$ — градиент не «затухает» так сильно. Плюс ReLU очень простой и быстрый.
Интуиция. ReLU — это выключатель: если сигнал положительный — пропускаем как есть, если отрицательный — обнуляем. Мозг тоже работает похоже: нейроны либо молчат, либо возбуждаются.
Dropout:
На каждом шаге обучения случайно выключаем часть нейронов (например, 50%). Оставшиеся нейроны вынуждены учиться работать без «подстраховки» отключенных коллег.
Интуиция. Представьте, что вы готовитесь к экзамену в группе. Если вы знаете, что на экзамене вас могут посадить одного, вы учите материал сами, а не надеетесь на шпаргалку соседа. Dropout заставляет каждый нейрон быть самодостаточным.
Batch Normalization:
Нормализуем активации внутри сети: для каждого мини-батча вычисляем среднее и дисперсию и приводим активации к нулевому среднему и единичной дисперсии:
$$ \hat{h} = \frac{h - \mu_B}{\sqrt{\sigma_B^2 + \varepsilon}}, \quad h_{\text{out}} = \gamma \hat{h} + \beta $$где $\gamma$ и $\beta$ — обучаемые параметры.
Интуиция. Когда вы меняете веса в первых слоях, распределение активаций на следующих слоях «плавает» — это называется internal covariate shift. Batch Normalization фиксирует распределение, и сеть учится стабильнее и быстрее. Это как выровнять пол в комнате, прежде чем ставить мебель.
5.5. Метрики и оценка#
Мы обучили модель. Как понять, хороша ли она? Просто «посчитать ошибки» недостаточно — нужно смотреть на разные аспекты качества.
Матрица ошибок (Confusion Matrix)#
Для бинарной классификации:
| Предсказан Positive | Предсказан Negative | |
|---|---|---|
| Реально Positive | TP (True Positive) | FN (False Negative) |
| Реально Negative | FP (False Positive) | TN (True Negative) |
- TP — мы правильно угадали положительный класс.
- TN — мы правильно угадали отрицательный класс.
- FP — ложная тревога (ошибка I рода).
- FN — пропуск цели (ошибка II рода).
Accuracy#
Доля правильных ответов:
$$ \text{Accuracy} = \frac{TP + TN}{TP + TN + FP + FN} $$Сначала — что такое TP, TN, FP, FN. Это четыре исхода «осмотра» модели, названные первой буквой (True/False) и второй — что модель сказала (Positive/Negative).
- TP (True Positive) — модель сказала «да», и это правда. Попала.
- TN (True Negative) — модель сказала «нет», и это правда. Попала.
- FP (False Positive) — модель сказала «да», а на самом деле «нет». Ложная тревога.
- FN (False Negative) — модель сказала «нет», а на самом деле «да». Пропуск.
Accuracy = «сколько раз попала из всех попыток». В числителе — все попадания ($TP + TN$), в знаменателе — все случаи вообще. Как процент правильных ответов на контрольной.
Пример: из 100 пациентов модель верно опознала 90 — accuracy $= 90\%$.
Когда хороша? Когда классы сбалансированы. Когда плоха? При дисбалансе. Пример: 95% здоровых, 5% больных. Модель, которая всем ставит «здоров», имеет accuracy 95% — но не обнаруживает ни одного больного! Это катастрофа.
Precision и Recall#
Precision (точность):
$$ \text{Precision} = \frac{TP}{TP + FP} $$Из всех, кого модель назвала положительными, сколько действительно положительные? Высокая precision = мало ложных тревог.
Здесь $TP$ — «по делу сказал да», $FP$ — «ложная тревога». Значит знаменатель $TP + FP$ — это «всё, что модель назвала положительным» (и правильно, и нет).
Формула = доля попаданий среди всех «да», которые выкрикнула модель.
- Модель сказала «да» 10 раз, из них 9 верно (TP=9) и 1 ошиблась (FP=1). Precision $= 9/(9+1) = 0{,}9$.
Смысл: «когда говорю “да”, насколько мне можно верить». Осторожная модель с высокой precision редко поднимает ложную тревогу. Метафора: рыбак, который тянет сеть и проверяет только один улов — Precision это «сколько из выловленного реально рыба».
Recall (полнота):
$$ \text{Recall} = \frac{TP}{TP + FN} $$Из всех реально положительных объектов сколько модель нашла? Высокий recall = мало пропусков.
Интуиция. Представьте поисковую систему. Precision: «из того, что я показал, сколько релевантно?» Recall: «из всего релевантного в интернете, сколько я показал?» Хотите и то и другое — но обычно есть trade-off.
F1-мера#
Гармоническое среднее precision и recall:
$$ F1 = 2 \cdot \frac{\text{Precision} \cdot \text{Recall}}{\text{Precision} + \text{Recall}} $$F1 наказывает за сильный дисбаланс между precision и recall. Если precision = 1, recall = 0, то F1 = 0. Если оба равны 0.8, то F1 = 0.8.
F1 — это «среднее по-честному» между Precision и Recall, которое не даёт одной метрике замаскировать плохую другую.
Почему не обычное среднее, а гармоническое (дробь с произведением сверху)? Потому что оно резко проваливается, если хотя бы одно из двух чисел близко к нулю.
- Precision $= 1$, Recall $= 0$: сверху $1 \cdot 0 = 0$, значит F1 $= 0$. Обычное среднее дало бы $0{,}5$ — обманчиво «нормально», а модель на самом деле бесполезна.
- Precision $= 0{,}8$, Recall $= 0{,}8$: сверху $0{,}64$, снизу $1{,}6$, F1 $= 2 \cdot 0{,}64/1{,}6 = 0{,}8$. Когда обе хороши — F1 тоже хорош.
Правило чтения: F1 высок только когда обе метрики высоки. Это единый «средний балл» качества классификатора.
Пример. Диагностика редкой болезни. Если модель говорит «болен» только в крайних случаях, precision может быть высокой (редко ошибается), но recall низким (пропускает больных). F1 покажет, что модель плоха, даже если accuracy высокая.
ROC-AUC#
ROC-кривая (Receiver Operating Characteristic) — это график TPR (True Positive Rate = Recall) против FPR (False Positive Rate = FP / (FP + TN)) при варьировании порога решения.
- TPR = Recall = TP / (TP + FN) — доля найденных положительных.
- FPR = FP / (FP + TN) — доля ложных тревог среди отрицательных.
AUC (Area Under Curve) — площадь под ROC-кривой. AUC = 1 — идеальная модель, AUC = 0.5 — случайное угадывание.
Интуиция. ROC-кривая показывает, как модель «торгует» между полнотой и ложными тревогами. AUC — это вероятность, что модель поставит случайному положительному объекту более высокий score, чем случайному отрицательному.
Пример. Модель кредитного скоринга. Меняя порог, мы можем одобрять кредиты только самым надёжным (высокий порог — низкий FPR, но и низкий TPR) или почти всем (низкий порог — высокий TPR, но и высокий FPR). ROC-кривая показывает все возможные компромиссы.
Кросс-валидация (Cross-Validation)#
Как оценить модель, не тратя все данные на тест? K-Fold Cross-Validation:
- Делим данные на $K$ частей (фолдов).
- Обучаем на $K-1$ частях, тестируем на оставшейся.
- Повторяем $K$ раз, каждый раз меняя тестовый фолд.
- Усредняем метрики по всем фолдам.
Интуиция. Вместо одного экзамена вы сдаёте $K$ разных экзаменов, каждый раз с новыми вопросами. Средняя оценка надёжнее, чем результат одного теста.
Типичные значения: $K=5$ или $K=10$. При малом количестве данных используют Leave-One-Out (LOO), где $K = N$ (число объектов).
Bias–Variance Decomposition#
Ошибка модели распадается на три компоненты:
$$ \text{Error} = \text{Bias}^2 + \text{Variance} + \text{Noise} $$- Bias (смещение) — ошибка из-за того, что модель слишком простая и не может уловить истинную закономерность. Высокий bias = недообучение.
- Variance (разброс) — ошибка из-за того, что модель слишком чувствительна к данным обучения. Высокая variance = переобучение.
- Noise (шум) — неустранимая ошибка из-за случайности в данных.
Интуиция. Представьте стрельбу по мишени:
- Высокий bias, низкая variance: стрелок всё время попадает в одно и то же место, но далеко от центра (систематическая ошибка).
- Низкий bias, высокая variance: стрелок в среднем целится в центр, но разброс большой (нестабильность).
- Низкий bias, низкая variance: идеально — кучно в центре.
Trade-off. Усложняя модель (больше слоёв, больше нейронов), мы снижаем bias, но повышаем variance. Регуляризация снижает variance ценой небольшого увеличения bias. Задача ML-инженера — найти золотую середину.
Ключевая мысль#
Перцептрон — это минимальная модель, на которой видны все основные идеи машинного обучения: линейная разделимость, градиентный спуск, функция потерь, обобщение. Дальнейшее развитие — логистическая регрессия, многослойные сети, регуляризация, современные архитектуры — это усложнение и уточнение тех же базовых принципов. Поймите перцептрон — и вы поймёте половину современного ML.
6. Практика в Jupyter Notebook (45 минут)#
Цель. Закрепить теорию кодом: всё, что было выведено на доске — правило обучения, обновление весов, сходимость, ограничения линейных моделей — мы теперь увидим вживую. Теорию проще понять, когда она перестаёт быть абстракцией и начинает работать на конкретных данных. Поэтому на этом занятии вы реализуете перцептрон с нуля на NumPy, проверите его на линейно разделимых данных и на XOR, сравните с готовыми реализациями из scikit-learn. Работайте в Jupyter Notebook и выполняйте шаги по порядку: каждый шаг даёт один важный вывод, а все вместе они складываются в полную картину.
6.1. Реализуем класс Perceptron на NumPy#
Первый и главный шаг — написать перцептрон с нуля. Никакой магии: это ровно та модель, которую мы разобрали математически, только в виде кода. Создайте класс Perceptron и реализуйте в нём два ключевых метода:
fit(X, y, eta, epochs)— обучает модель: принимает матрицу признаков $X$, вектор ответов $y$, темп обучения $\eta$ и число эпохepochs, а внутри цикла по эпохам обновляет веса.predict(X)— вычисляет предсказания: для каждой строки $x$ возвращает $\hat{y} = \operatorname{sign}(w^T x + b)$, где $w$ — вектор весов, $b$ — смещение (bias).
В методе fit реализуйте правило обучения, выведенное на лекции: для каждого ошибочно классифицированного примера $(x, y)$ веса и смещение сдвигаются в сторону исправления ошибки:
Интуиция: если модель ошиблась, значит, знак $w^T x + b$ не совпал со знаком $y$. Добавление $\eta \cdot y \cdot x$ к весам поворачивает разделяющую прямую так, чтобы для этого примера ответ стал правильным. Bias обновляется по той же логике — это фактически вес при фиктивном признаке, всегда равном $1$.
Обязательно проверьте, что модель обучается на простом примере до того, как переходить дальше: это избавит вас от долгих поисков багов на следующих шагах.
6.2. Генерируем линейно разделимые данные#
Перцептрон сходится только на линейно разделимых данных, поэтому для первого запуска нам нужен именно такой набор. Возьмите sklearn.datasets.make_blobs — он создаёт облака точек вокруг заданных центров — либо сгенерируйте данные вручную, например, выборкой из двух гауссовых распределений со сдвинутыми средними.
Что и зачем делать по шагам:
- Создайте два класса точек так, чтобы между ними можно было провести прямую линию, разделяющую их без ошибок.
- Сформируйте матрицу признаков $X$ (строки — примеры, столбцы — признаки) и вектор меток $y$.
- Переведите метки классов в значения $\{+1, -1\}$: перцептрон обучен работать именно с такими ответами, а не с $\{0, 1\}$.
Пример: два облака по 50 точек: одно с центром около $(2, 2)$, другое около $(6, 6)$ — между ними легко провести разделяющую прямую. На таких данных перцептрон обязан сойтись.
6.3. Обучаем перцептрон и визуализируем разделяющую прямую#
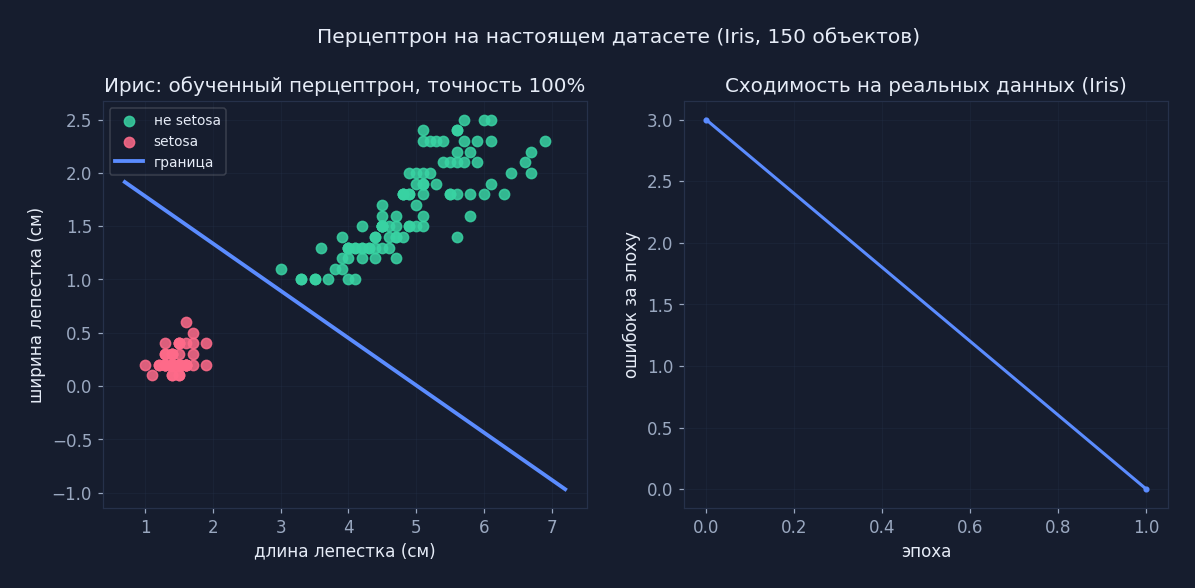
Обучите реализованный перцептрон на сгенерированных данных. Главный результат этого шага — не число, а картинка: постройте scatter-график точек обоих классов и нанесите на него разделяющую прямую.
Уравнение прямой, которую строит перцептрон, получается из условия $w^T x + b = 0$. Для двух признаков $x_1, x_2$ это:
$$ w_1 x_1 + w_2 x_2 + b = 0 \quad \Rightarrow \quad x_2 = -\frac{w_1}{w_2}\, x_1 - \frac{b}{w_2}. $$Это превращение — обычная школьная алгебра, просто выглядит грозно. Покажем шаг за шагом.
Исходно: $w_1 x_1 + w_2 x_2 + b = 0$. Хотим выразить $x_2$ через $x_1$, чтобы нарисовать график «$y$ от $x$».
1. Перенесём всё, кроме слагаемого с $x_2$, вправо: $w_2 x_2 = -w_1 x_1 - b$. 2. Поделим на $w_2$: $x_2 = -\frac{w_1}{w_2} x_1 - \frac{b}{w_2}$.
Всё. Это уравнение вида $y = kx + c$ — самая обычная прямая.
- Наклон $k = -w_1/w_2$ — как прямая наклонена.
- Сдвиг $c = -b/w_2$ — где она пересекает вертикальную ось.
Смысл: зная обученные веса $w_1, w_2, b$, мы можем нарисовать прямую из двух чисел — наклона и сдвига. Именно так демо рисует границу на графике.
Проведите эту прямую на графике: она должна разделить классы, а её наклон и сдвиг определяются тем, какими вышли обученные веса.
Зачем это нужно: визуализация превращает абстрактные веса в геометрический образ. Вы своими глазами видите, что обучение перцептрона — это подбор прямой, которая разделяет данные: модель нашла её, вращая и сдвигая прямую по мере исправления ошибок. Если прямая легла неправильно — проверьте порядок признаков, метки и знак в правиле обновления.
6.4. Запускаем перцептрон на XOR — смотрим, как ошибка не сходится#
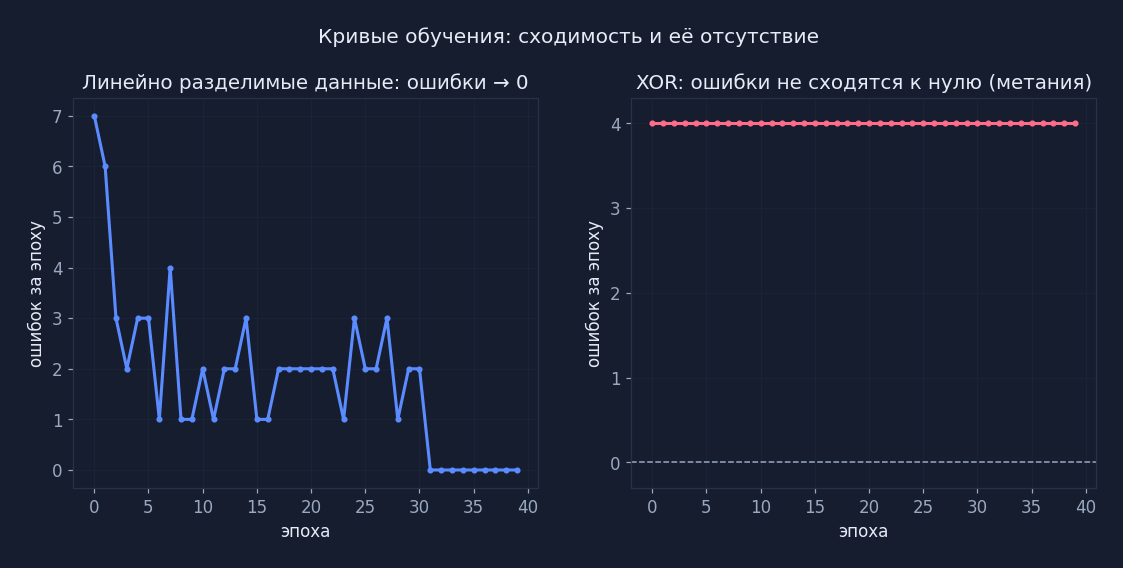
Теперь ключевой эксперимент теории. Сгенерируйте точки, соответствующие логической операции XOR: $(-1, -1) \to -1$, $(-1, 1) \to +1$, $(1, -1) \to +1$, $(1, 1) \to -1$ (или в координатах $\{0, 1\}$). Обучите тот же перцептрон и постройте график ошибки по эпохам.
Что вы увидите: в отличие от линейно разделимого случая, ошибка не сходится к нулю — она колеблется около ненулевого уровня и не падает, сколько бы эпох вы ни запускали. Никакой прямой линией четыре точки XOR не разделить: классы перемешаны «крест-накрест», и линейный классификатор физически не в состоянии провести границу.
Интуиция: XOR — это встроенный «тест на профпригодность» для линейных моделей. Если перцептрон не может сойтись на таком простом наборе, значит, проблема не в реализации, а в самой модели: ей не хватает выразительности. Именно это наблюдение исторически привело к идее скрытых слоёв и многослойных сетей.
6.5. Сравниваем со sklearn.linear_model.Perceptron и LogisticRegression#
Реализация с нуля нужна не для того, чтобы заменить библиотеки, а для понимания. Теперь сравните своё решение с готовыми инструментами:
- Обучите
sklearn.linear_model.Perceptronна тех же данных и сравните качество и разделяющие прямые со своей реализацией — они должны практически совпадать. - Обучите
LogisticRegression— она решает ту же задачу бинарной классификации, но использует гладкую сигмоидальную функцию активации и максимизацию правдоподобия вместо ступенчатого правила обновления.
Сравните результаты на линейно разделимых данных и на XOR. Важный вывод: на XOR обе модели дают плохой результат, потому что обе они линейны, — разница между перцептроном и логистической регрессией проявляется не в способности решать XOR, а в устойчивости, калибровке вероятностей и поведении на зашумлённых данных.
Зачем это нужно: вы учитесь сопоставлять своё понимание (реализация с нуля) с индустриальным инструментарием (scikit-learn) и видите, что алгоритмы одного семейства имеют общие ограничения, независимо от того, кто их написал.
6.6. Строим график ошибки по эпохам#
Добавьте в fit сбор истории: после каждой эпохи запоминайте число ошибок (или значение ошибки) на обучающей выборке. Затем постройте график «ошибка от номера эпохи».
- На линейно разделимых данных кривая должна монотонно убывать и дойти до нуля за конечное число эпох — это живая иллюстрация теоремы сходимости.
- На XOR кривая никогда не достигает нуля — наглядно видно, что сходимости нет.
Интуиция: график ошибки — это «пульс» обучения. По его форме сразу видно, учится ли модель, застревает ли она в колебаниях и когда останавливаться. Такой график — стандартный диагностический инструмент в машинном обучении, он пригодится вам во всех дальнейших моделях.
6.7. Настоящие данные: от медицины до подделок банкнот#
До сих пор мы работали с синтетическими точками. Но перцептрон ценен именно тем, что на реальных задачах он работает — и работает достойно. Посмотрим на пять настоящих датасетов.
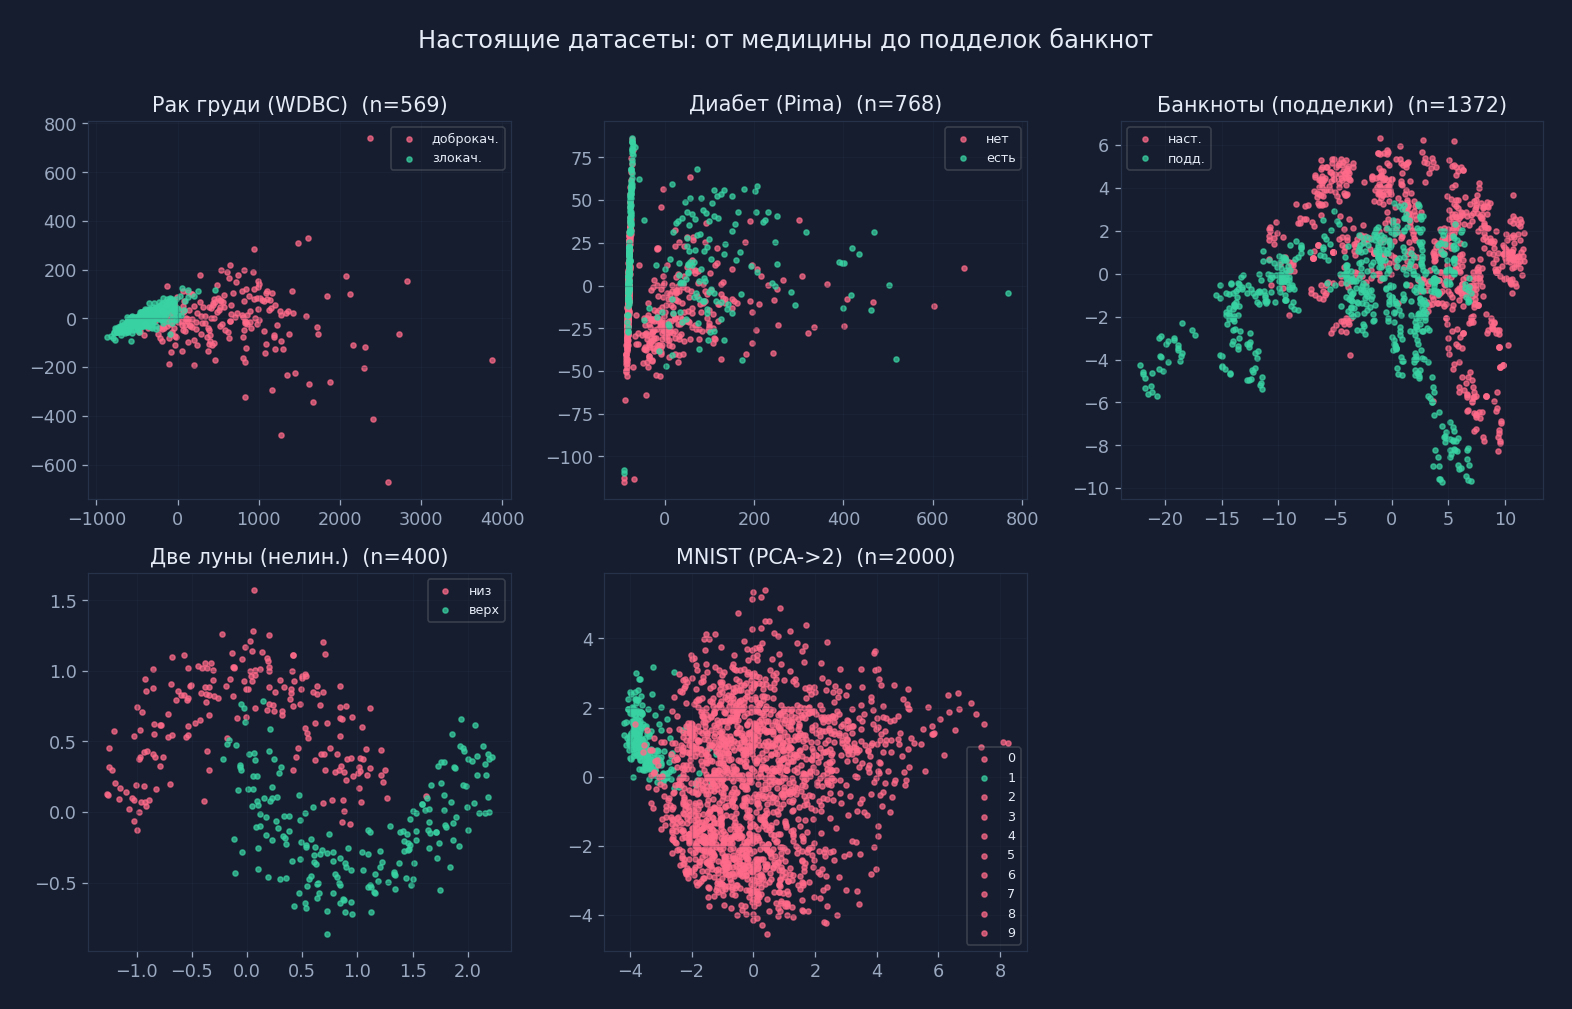
Здесь пять совершенно разных задач: медицинская диагностика рака груди (WDBC, 569 пациентов, 30 измерений), предсказание диабета по анализам (Pima, 768 женщин), распознавание поддельных банкнот (1372 купюры), нелинейная игрушка «две луны» и MNIST — 70 000 рукописных цифр.
Обучим на каждом бинарном наборе обычный перцептрон и логистическую регрессию и сравним точность на отложенной тестовой выборке (30%).
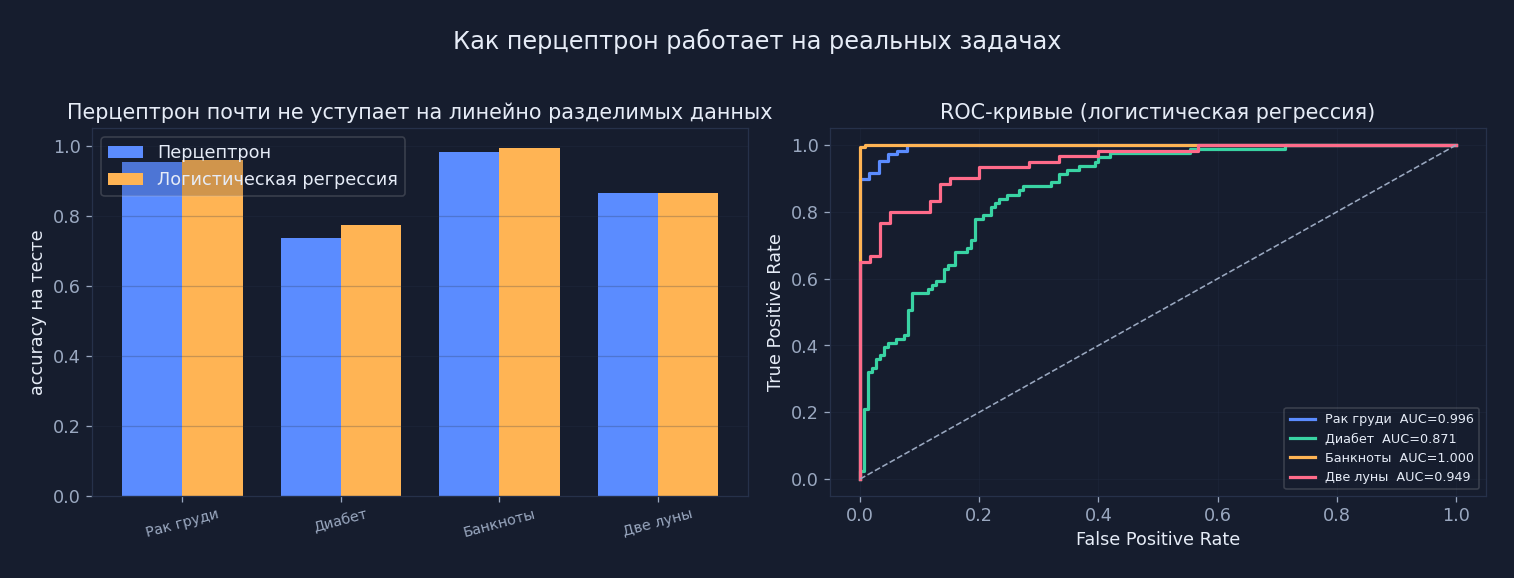
Числа красноречивы:
- Рак груди (WDBC): перцептрон 95.3%, логистическая регрессия 95.9%. Задача диагностики злокачественных опухолей почти линейна — опухоли действительно различаются по размеру ядра клеток; AUC = 0.996.
- Диабет (Pima): 73.6% против 77.5%. Здесь сложнее: признаки перемешаны, много шума, диагноз не сводится к простой прямой — поэтому перцептрон «не дотягивает», а вероятностная модель выигрывает.
- Банкноты (подделки): 98.3% против 99.3%. Купюры различаются по геометрии изображения почти линейно, обе модели почти идеальны (AUC = 1.000).
- Две луны: обе модели дают 86.7% — и обе упираются в свою линейность: две переплетающиеся «луны» нельзя разделить прямой, нужен нелинейный классификатор.
Интуиция: сравнение показывает главное. Перцептрон — не игрушка для XOR; на реальных, почти линейно разделимых задачах он даёт результат, близкий к логистической регрессии, при куда меньшей вычислительной стоимости. Проигрывает он там, где данные заведомо нелинейны или сильно зашумлены.
6.8. От перцептрона к реальному обучению на GPU#
Выше мы обучали модели scikit-learn на CPU. Но современный конвейер «линейная модель → многослойная сеть» удобнее всего показать на GPU. Обучим на видеокарте настоящую нейросеть на MNIST: та же идея — линейные комбинации и нелинейности, что и в перцептроне, только слоёв больше, а обучение идёт методом обратного распространения.
Архитектура проста: вход 784 (пиксели 28×28), скрытый слой 256 нейронов с ReLU, выход 10 классов. Четыре эпохи на NVIDIA RTX 5090:
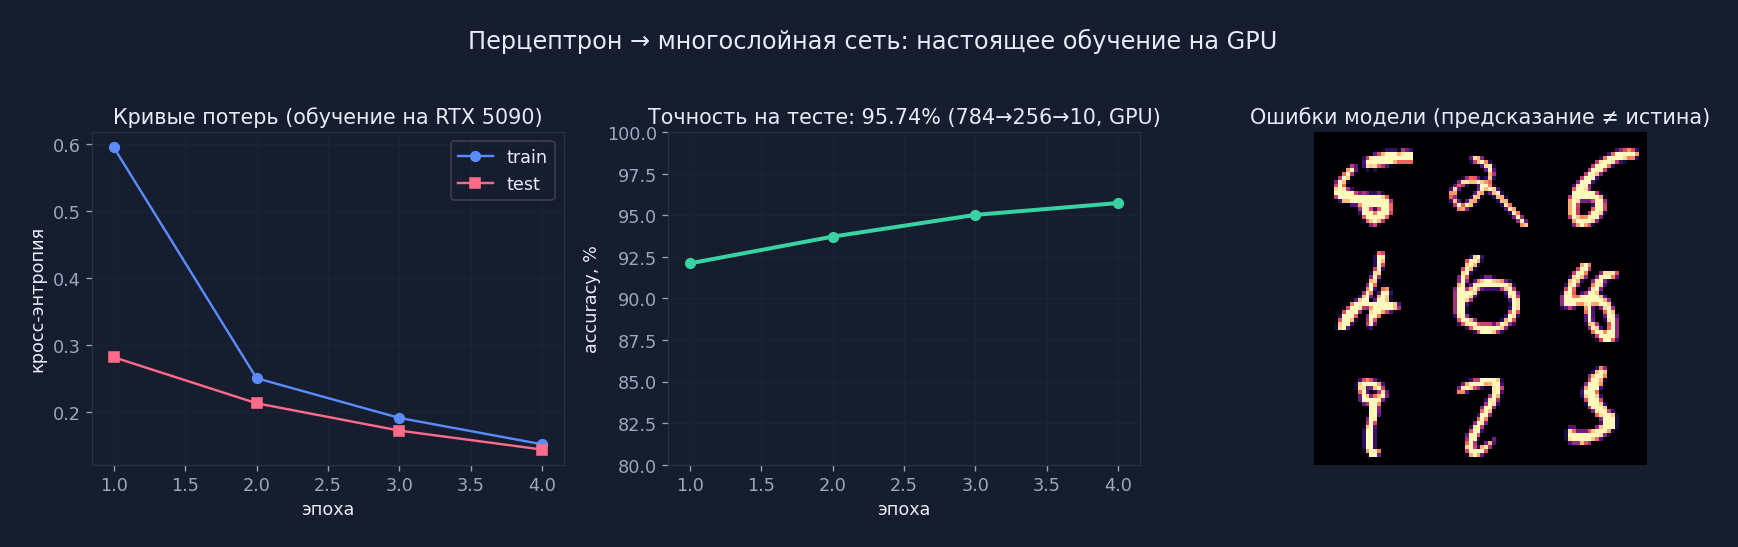
Модель стартовала с 92.1% после первой эпохи и дошла до 95.7% точности на тесте за четыре эпохи. Справа — примеры её ошибок: цифры, которые и человек прочитает двояко.
Теперь сравним с однослойным случаем. Тот же MNIST, но классификатор без скрытого слоя — обычный перцептрон на 784 признаках:
- Однослойный перцептрон: 85.5% точности.
- Логистическая регрессия: 90.3%.
- Многослойная сеть (GPU), 4 эпохи: 95.7%.
Разрыв между 85.5% и 95.7% — это цена, которую платит линейная модель за нелинейность данных: один скрытый слой даёт скачок почти на 10 процентных пунктов. Именно так идея перцептрона превращается в глубокое обучение.
Интуиция: перцептрон — это крайний (линейный, однослойный) случай целого спектра современных моделей. Усложняя его — добавляя скрытые слои, нелинейные активации, обучение на GPU — мы получаем нейросети. Поняв перцептрон, вы поняли фундамент, на котором они стоят.
6.9. Дополнительные задания (по желанию, для углубления)#
Когда основные шаги пройдены, попробуйте расширить реализацию. Каждое задание проверяет конкретный теоретический вопрос на практике:
- Добавить L2-регуляризацию. Модифицируйте правило обновления, добавив штраф за величину весов: $w \leftarrow w + \eta (y x - \lambda w)$. Зачем: посмотрите, как регуляризация уменьшает веса и как это влияет на обобщение на шумных данных.
- Реализовать многоклассовый one-vs-all. Обучите по одному перцептрону на каждый класс против всех остальных и выбирайте класс с максимальным откликом. Зачем: убедитесь, что бинарный классификатор превращается в многоклассовый простым приёмом «каждый против всех».
- Сравнить online и batch режимы. В online-режиме веса обновляются после каждого примера, в batch — по накопленному за эпоху обновлению. Зачем: почувствуйте разницу в скорости сходимости и стабильности.
- Исследовать влияние $\eta$ и масштабирования признаков. Прогоните обучение с разными темпами (например, $\eta = 0.01, 0.1, 1.0$) и сравните данные в исходном масштабе и после стандартизации. Зачем: увидите, что слишком большой $\eta$ даёт колебания, а несогласованные масштабы признаков замедляют сходимость.
Итог раздела: практика в Jupyter Notebook переводит всю теорию перцептрона в работающий код. Мы реализовали обучение с нуля на NumPy, увидели на графиках, как строится разделяющая прямая, и убедились на XOR, что линейная модель не сходится на нелинейно разделимых данных. Сравнение со scikit-learn подтвердило корректность нашей реализации, а график ошибки по эпохам стал визуальной иллюстрацией теоремы сходимости. Дополнительные задания — регуляризация, one-vs-all, режимы обновления и настройка $\eta$ — закрепляют понимание того, как выбор алгоритма и гиперпараметров влияет на результат.
7. Итоги, вопросы, домашнее задание (15 минут)#
Мы прошли путь от биологической идеи нейрона до работающей модели. Соберём воедино ключевые выводы, зафиксируем домашнее задание и проверим себя вопросами для самопроверки. Если вы можете ответить на них без конспекта — материал усвоен.
7.1. Ключевые выводы#
- Однослойный перцептрон — линейный классификатор. Он разделяет пространство признаков прямой (гиперплоскостью) и потому решает только линейно разделимые задачи. Вся его «интеллектуальность» — это подбор параметров $w$ и $b$ такой прямой.
- Обучение — подстройка весов по ошибке. Модель смотрит на каждый ошибочно классифицированный пример и сдвигает веса в сторону исправления: $w \leftarrow w + \eta \cdot y \cdot x$. Ошибка — двигатель обучения: нет ошибки — нет обновления.
- Теорема сходимости гарантирует решение для линейно разделимых данных. Если данные можно разделить прямой, перцептрон найдёт разделяющую прямую за конечное число шагов — при подходящем темпе обучения и без учёта зазора между классами.
- XOR и нелинейные задачи требуют скрытых слоёв. Никакая прямая не разделит «крест-накрест» четыре точки XOR, поэтому однослойная модель здесь обречена. Решение — добавить скрытые слои, которые строят более сложные (нелинейные) границы.
- Перцептрон — фундамент для логистической регрессии, SVM, нейросетей. Многие более мощные модели — это эволюция той же идеи «линейная комбинация признаков + нелинейная функция активации + обучение по ошибке»: логистическая регрессия заменила ступеньку на сигмоиду, SVM добавила понятие зазора, нейросети — скрытые слои.
Интуиция: запомните главную мысль всего курса — перцептрон прост, но именно понимание его ограничений (линейность) и механизма обучения (обновление по ошибке) даёт ключ ко всем современным моделям машинного обучения.
7.2. Домашнее задание#
Домашнее задание построено так, чтобы вы ещё раз прошли весь материал самостоятельно — от математики до эксперимента:
- Вывести правило обучения перцептрона из перцептронного критерия. Запишите функцию потерь как сумму вкладов ошибочно классифицированных примеров и возьмите градиентный шаг — правило обновления должно получиться автоматически.
- Доказать неразделимость XOR. Покажите, что не существует прямой, отделяющей точки одного класса XOR от точек другого, — например, перебором всех вариантов расположения прямой или через противоречие с линейностью.
- Реализовать перцептрон с нуля и обучить на двух наборах: линейно разделимом и XOR. Повторите шаги из практики: на первом наборе ошибка должна сойтись к нулю, на втором — нет.
- Сравнить с логистической регрессией. Обучите оба алгоритма на одних данных и сравните качество, разделяющие границы и поведение на неразделимых наборах.
- Написать краткий отчёт: история, математика, эксперименты, ограничения. Соберите всё в один текст: как появился перцептрон, как устроена его математика, что показали ваши эксперименты и где проходят границы применимости модели.
7.3. Вопросы для самопроверки#
Проверьте себя: если ответ на вопрос не получается сформулировать своими словами — вернитесь к соответствующему разделу лекции.
- Почему перцептрон не решает XOR? Потому что XOR не является линейно разделимой задачей: классы нельзя отделить одной прямой, а однослойный перцептрон умеет строить только прямолинейные границы.
- Что такое зазор и как он влияет на сходимость? Зазор — это минимальное расстояние от точек обучающей выборки до разделяющей гиперплоскости: $\gamma = \min_i \frac{|w^T x_i + b|}{\|w\|}$. Чем больше зазор, тем «увереннее» разделение и тем быстрее и стабильнее сходится обучение; при отсутствии зазора (точки почти на границе) перцептрон может долго колебаться.
- Чем ADALINE отличается от перцептрона? ADALINE обучается по непрерывному выходу (линейная комбинация до порога) и использует гладкую функцию потерь (средний квадрат ошибки), тогда как перцептрон обучается по бинарному ответу после пороговой функции и исправляет только ошибочные примеры.
- Как перцептрон связан с логистической регрессией? Это одно семейство линейных моделей: логистическая регрессия заменяет ступенчатую функцию активации перцептрона на гладкую сигмоиду и вместо «штрафа за ошибку» максимизирует вероятность данных, что даёт вероятностные предсказания и более устойчивое обучение.
- Что такое VC-размерность и зачем она нужна? VC-размерность измеряет выразительность (ёмкость) класса моделей — максимальное число точек, которые модель может разделить во всех возможных вариантах. Она нужна, чтобы понимать, насколько сложные закономерности способна выучить модель и как это соотносится с риском переобучения.
Итог раздела: главный вывод лекции — однослойный перцептрон это линейный классификатор, который учится подстройкой весов по ошибке и гарантированно сходится на линейно разделимых данных, но бессилен перед XOR и другими нелинейными задачами. При этом он закладывает фундамент для логистической регрессии, SVM и нейросетей. Домашнее задание требует вывести правило обучения из критерия, доказать неразделимость XOR, реализовать модель и сравнить её с логистической регрессией, а вопросы для самопроверки помогают убедиться, что каждый ключевой пункт — от зазора до VC-размерности — действительно понят.